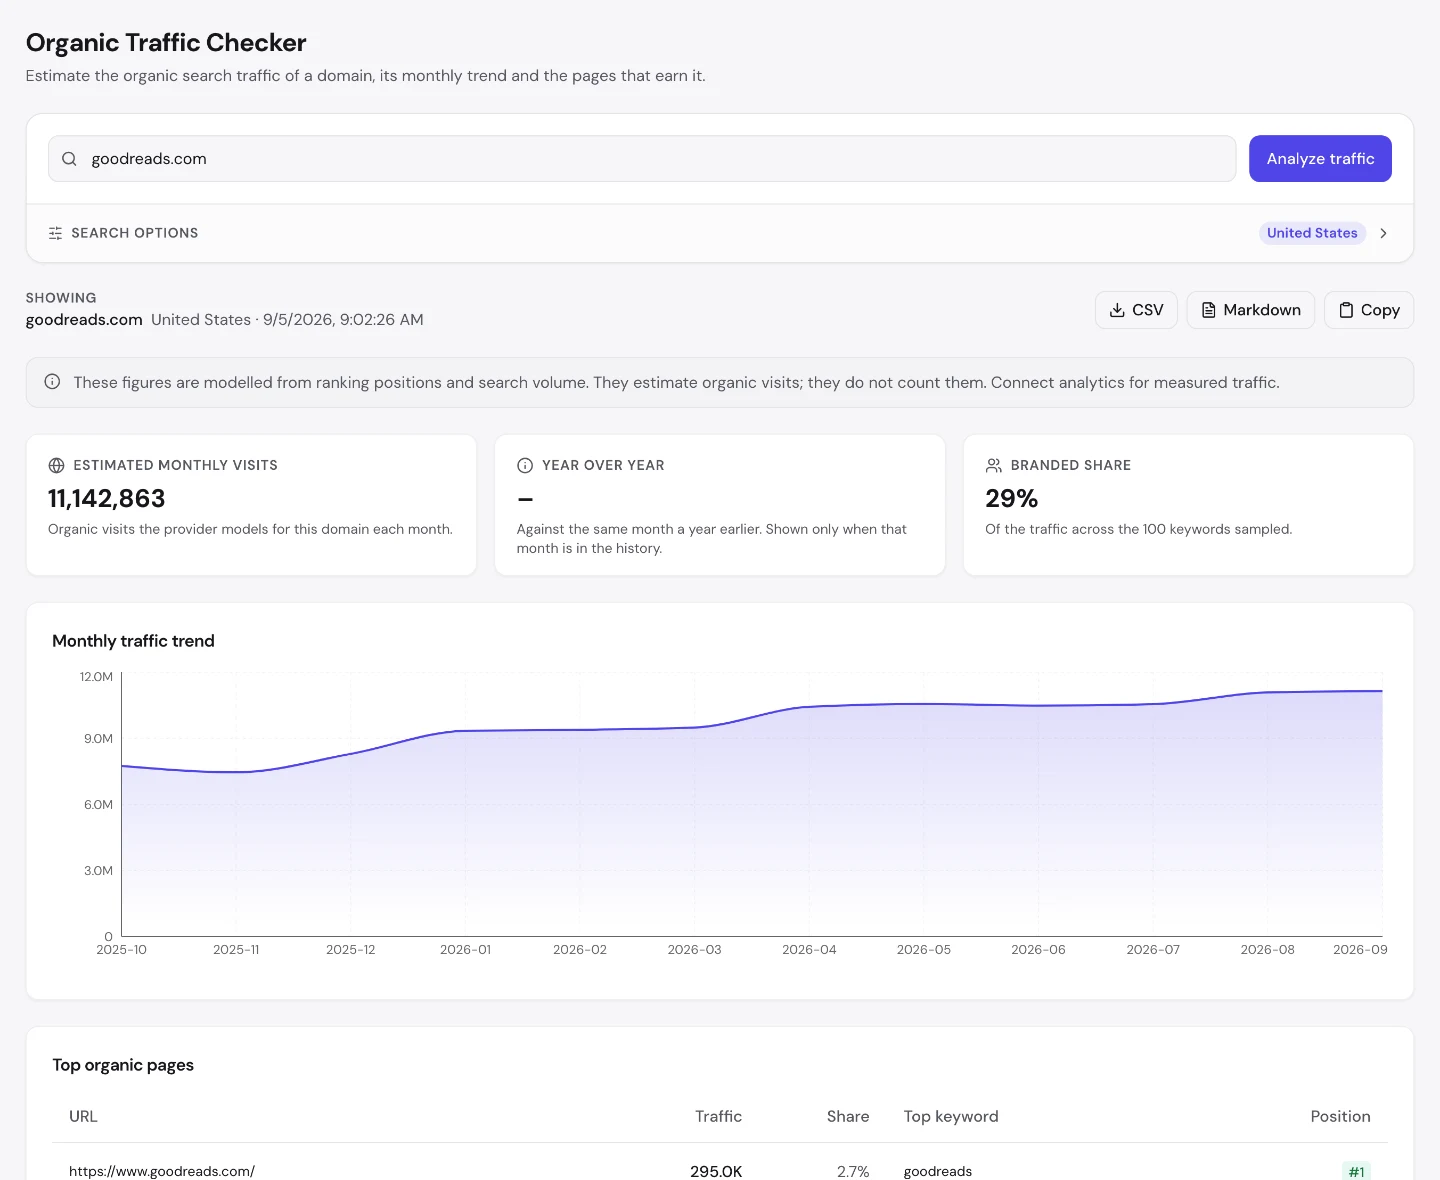
Goodreads ранжується за 11,1 млн ключових слів і отримує 11,1 млн візитів, майже рівно 1 візит на ключове слово.
Жодна окрема сторінка не несе навіть 3% із них. Головна бере 3%, а все після неї сидить нижче 1%.
Я прогнав goodreads.com через 4 наші інструменти. Це найрівніший великий сайт у цій серії, його сторінки окремих книжок справді ранжуються, чого майже не буває зі сторінками сутностей на цих 19 сайтах, а його сторінки цитат роблять те, чого ніхто не планує. Ось 8 уроків.
Читайте свою концентрацію як міру ризику
Наш Organic Traffic Checker дає Goodreads приблизно 11,1 млн оцінених візитів на місяць, і головна сторінка бере лише 3%. Усе після неї сидить нижче 1%.
Це безкоштовно, і воно показує форму. Щоб знайти тип сторінок, якого ніхто не планував, потрібен повний експорт усього, за чим ви ранжуєтеся, а саме це Semrush і SE Ranking роблять справді добре.
Рівніші лише Healthline і NHS.uk з їхньою спільною структурною перевагою, яка у вас може бути, а може й ні: величезний набір дрібних постійних запитів, де ніщо не домінує.
А тепер порівняйте з chess.com, де головна сторінка, це 58% трафіку. Обидва, це каталожні сайти. Один переживе втрату позиції, а другий ні.
Тож читайте власну концентрацію як міру ризику, а не як привід пишатися. Відкрийте звіт топових сторінок і складіть перші 3. Якщо разом вони дають більше половини трафіку, ви за одне оновлення алгоритму від поганого кварталу, і про це краще знати заздалегідь, а не потім.
Перевірте 20 назв сутностей, перш ніж генерувати їх
Ось найважливіше, і воно закриває суперечку, яка тягнеться через усю серію.
To Kill a Mockingbird стоїть на 2 місці. What Is the What стоїть на 1 місці. Сторінки окремих сутностей, і це в топ-5 сайту, який отримує 11 млн візитів.
На 19 сайтах сторінки сутностей майже ніколи не спрацьовували. У PyPI нічого не заробляють сторінки пакетів. У chess.com нічого не заробляють профілі гравців. У freeCodeCamp нічого не заробляють сторінки авторів.
Єдині винятки, це книжки Goodreads і записи досліджень у ClinicalTrials.gov, і обидва працюють з однієї причини. Назву книжки люди вже шукають. Нікнейм і назву пакета, ні.
Тож зробіть тест до того, як братися, бо він займає 5 хвилин і рятує вам квартал. Візьміть 20 назв сутностей із власної бази і закиньте їх у Keyword Research.
Якщо більшість повернеться без обсягу, ви збираєтеся генерувати склад. Жодні зміни в шаблоні цього не виправлять, і ви цілий рік дивуватиметеся, чому сторінки так і не пішли.
Шукайте шар, який ніхто не проєктував
Друга за величиною сторінка Goodreads, це /quotes, і вона стоїть на 2 місці за голим словом «quotes».
Не «book quotes». Не «literary quotes». Одне загальне слово, один із найбільш високочастотних запитів в інтернеті, і тримає його книжковий сайт.
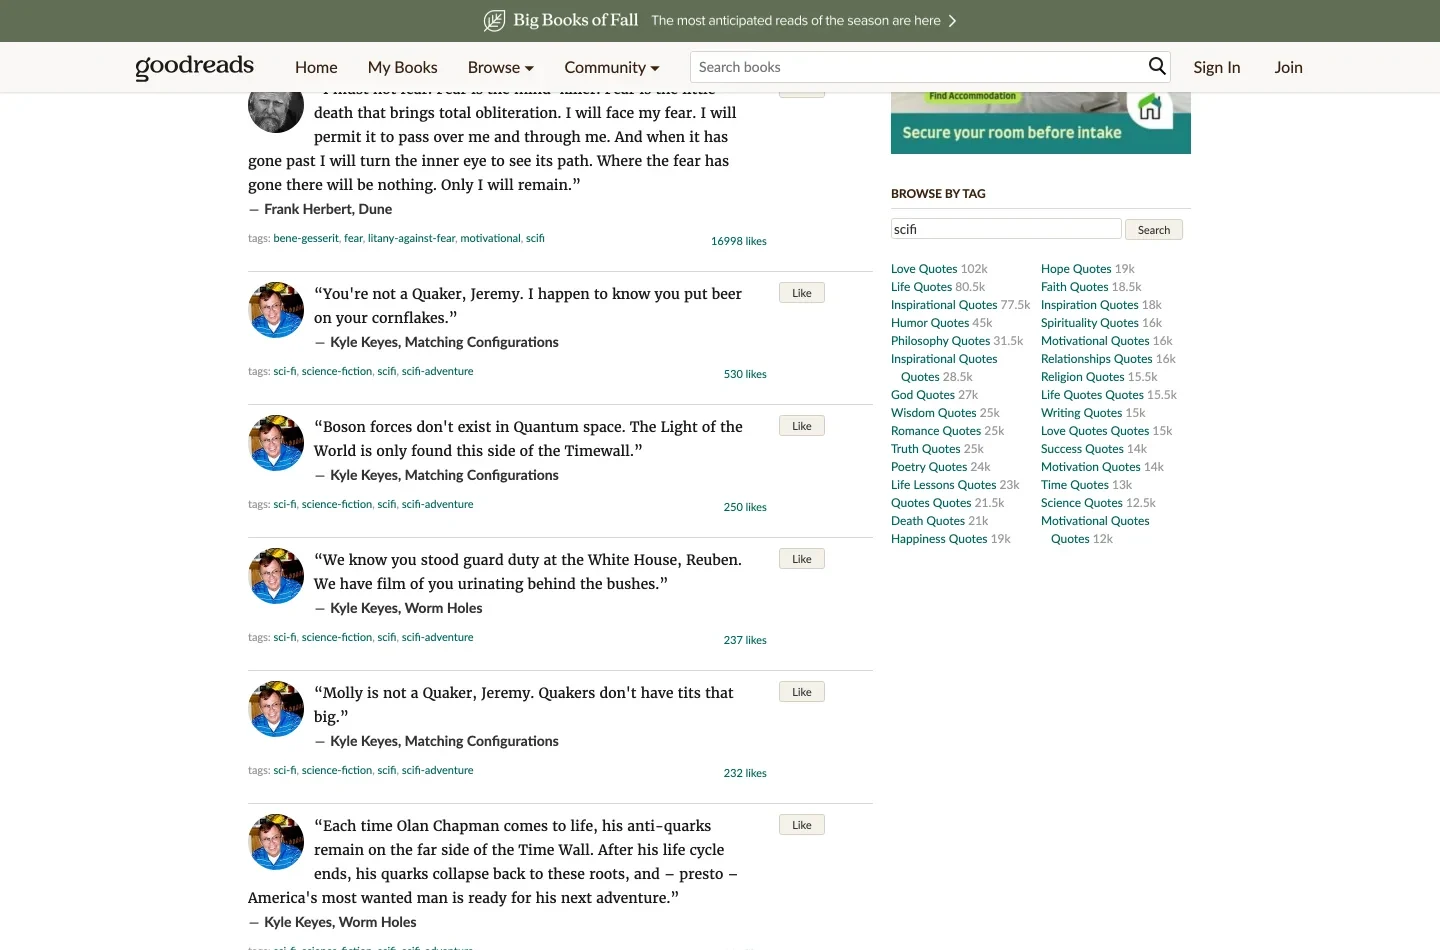
За нею стоїть величезний архів цитат, де кожен запис несе теги, що ведуть на нові сторінки цитат, тобто шар агрегації, який не має нічого спільного з рецензуванням книжок.
Ось шаблон, який серія видає знову і знову: шар, якого ніхто не вписав би в продуктову специфікацію, і є тим шаром, що ранжується. itch.io з каталогами тегів, Eventbrite зі сторінками перегляду, Dribbble з архівами тегів, TED з кошиками за роками, а тепер Goodreads із цитатами.
Тож підіть і подивіться, що ваш сайт породжує як побічний ефект: фільтри, архіви, сторінки-побічні продукти, за які ніхто не відповідає. Одна з них, найімовірніше, ближча до високочастотного запиту, ніж будь-що з вашого роудмапу, і цього ніхто не помітив, бо це ніколи не було нічиїм проєктом.
Тегуйте кожну цитату, яку публікуєте
Механізм, який можна скопіювати, і він дешевий.
Кожна цитата на Goodreads несе 3 або 4 теги, і кожен тег веде на сторінку з іншими цитатами на цю тему. Сама лише добірка цитат про любов тримає понад 100 тис. записів.
Тож архів будує власний граф внутрішніх посилань і власні сторінки категорій із метаданих, які автори додають зі своїх власних міркувань. Ніхто не планував таксономію під ключові слова.
Це можна скопіювати з будь-яким контентом, що має природні атрибути. Дозвольте людям тегувати, перетворюйте кожен тег, що перетнув поріг, на індексовану сторінку, і хай таксономія росте сама.
Єдина дисципліна, яка вам потрібна, це поріг. Перевірте, у яких тегів є справжній попит, у Keyword Cluster tool і лише потім індексуйте їх, інакше опублікуєте тисячі сторінок по 2 позиції на кожній і зведете всю користь нанівець.
Goodreads отримує велику частку трафіку зі сторінок цитат, яких ніхто не планував як канал зростання. У більшості сайтів такий шар теж є. Знайти його, це тиждень аналізу, а не рік здогадок.
- Знаходимо тип сторінок, який уже тихо працює
- Будуємо його як слід і в масштабі
- SEO і GEO, щоб утримати здобуте
- Безкоштовна консультація без зобов’язань
Чекайте від кожної сторінки цівки
За даними Domain Overview: 11,1 млн органічних ключових слів проти 11,1 млн візитів, при середній позиції 37.
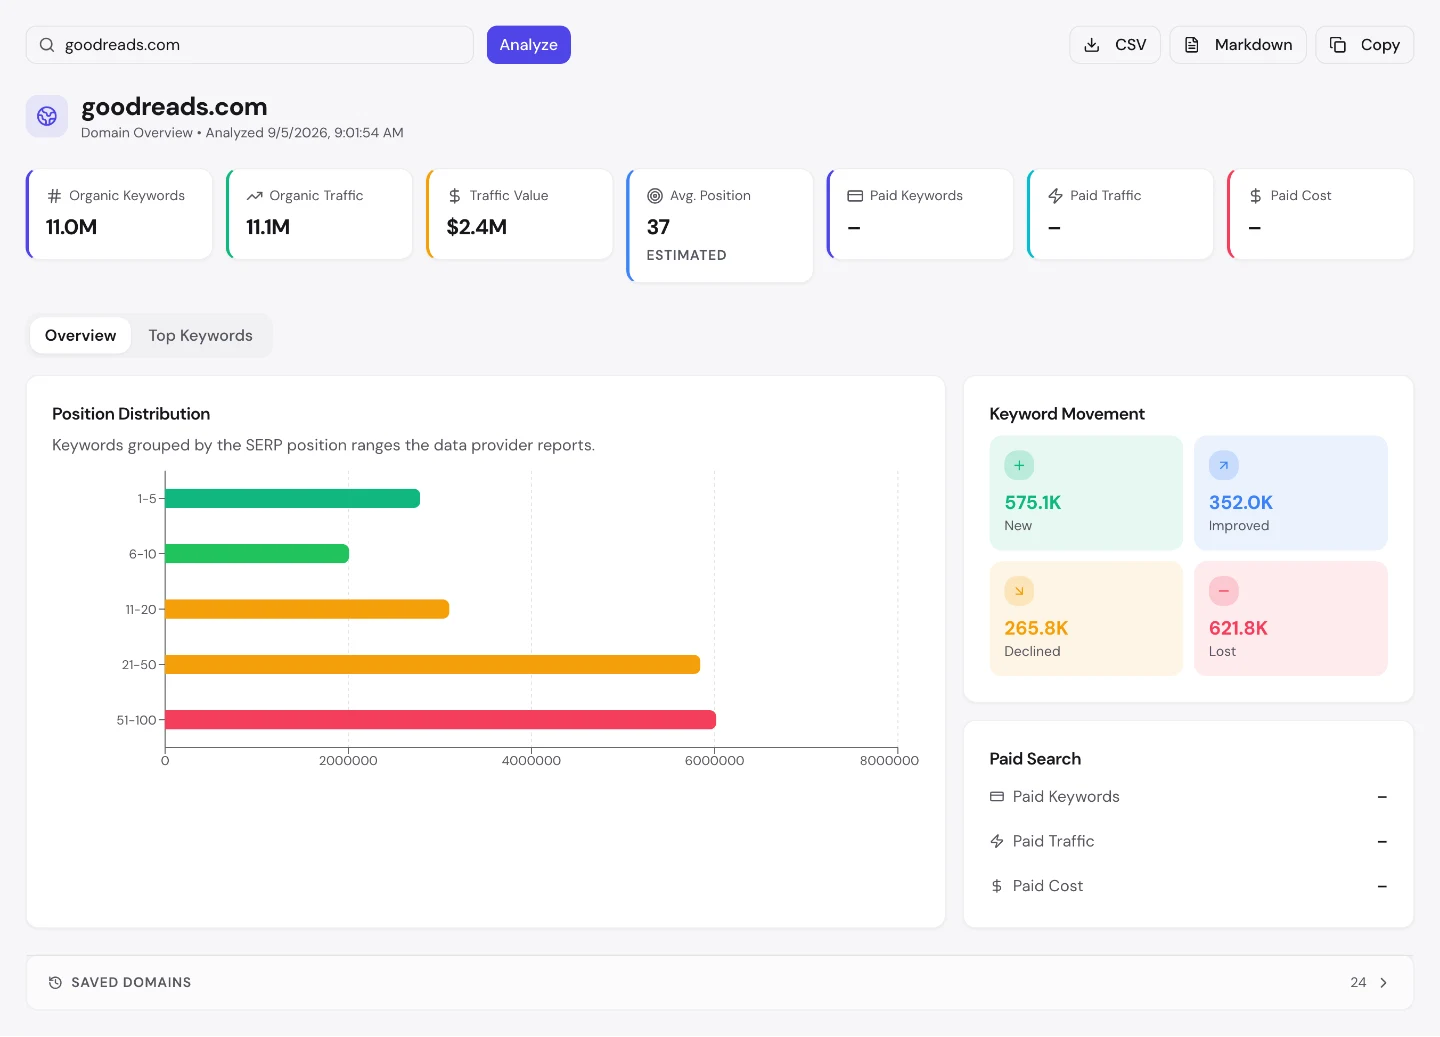
1 візит на одне ранжоване ключове слово. Це точно описує форму: мільйони сторінок, кожна ранжується за жменею запитів і кожна приносить цівку.
Позиція 37, це спільне 2 місце в серії, і це високо для каталогу такого розміру, бо назви книжок достатньо конкретні, щоб вигравати начисто.
Якщо у вас щось подібне, налаштуйте очікування на цівку з кожної сторінки і плануйте обсяг відповідно. Сторінка, яка дає 3 візити на місяць, у цій моделі не провал, вона одиниця виміру. Важливо інше: чи можете ви робити їх достатньо і дешево, і чи хтось узагалі шукає те, про що кожна з них.
Дивіться на колонку втрачених, а не на підсумок
Він втрачає більше ключових слів, ніж набуває, хоча за якістю росте, це третій каталог у серії, який стискається попри додавання записів.
Книжки не мають терміну придатності, як події чи пакети, тож плинність тут радше про малопомітні видання і дублі записів, що випадають з індексу, ніж про релевантність. У вашому каталозі буде щось таке саме: записи, за якими ви б не скучили, тихо йдуть.
Саме тому щомісяця дивіться на колонку втрачених, а не на підсумок. На базі в 11 млн ключових слів втрата 620 тис. зникає всередині заголовка, де й далі написано «11 мільйонів», і ви можете стискатися цілий рік, а цифра у звіті навіть не зрушить.
Лагодьте критичне, ігноруйте оцінку
Наш Website Audit дає головній сторінці 74/100, і 1 критична проблема лишається невиправленою.
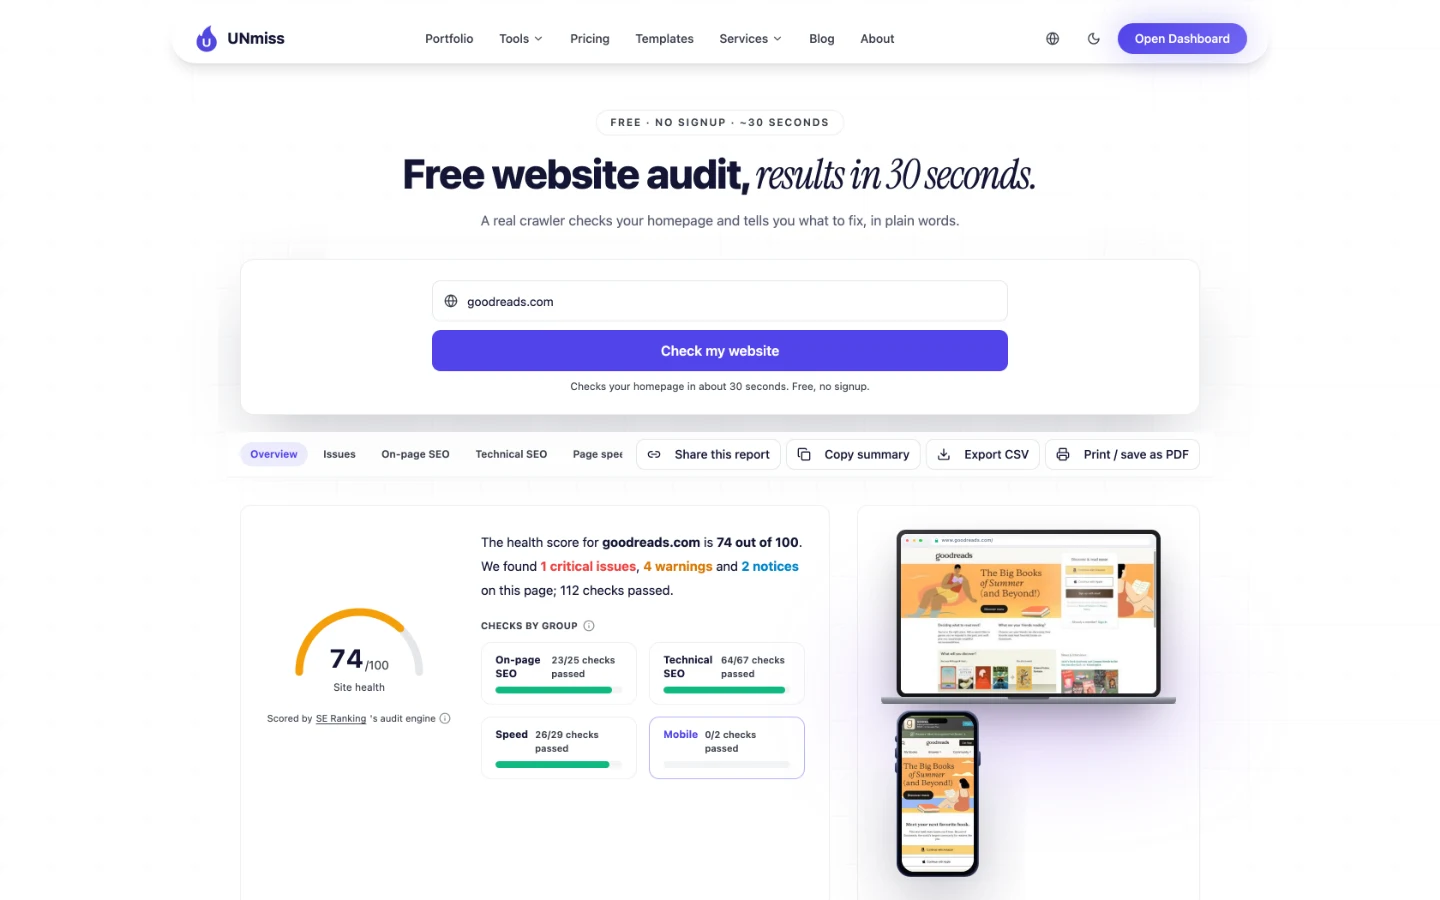
Спільне останнє місце в серії, і це на сайті з 11,1 млн візитів на місяць.
А от Dribbble і ClinicalTrials.gov отримали ідеальні 100 і обидва стискаються. За 19 сайтів оцінка аудиту не передбачила нічого.
Тож полагодьте критичні проблеми, бо вони конкретні й дешеві, а потім перестаньте дивитися на підсумкову цифру. Якщо оцінка низька, а трафік нормальний, у вас усе гаразд. Якщо оцінка ідеальна, а трафік стоїть, вона і не збиралася пояснювати чому.
Ставте дату біля кожної цифри посилань, яку публікуєте
Станом на 23 серпня 2026 року наш Backlink Analyzer поміряв Goodreads на Domain Rank 97, із 290 тис. доменів-донорів. Це один із найсильніших профілів у цій роботі.
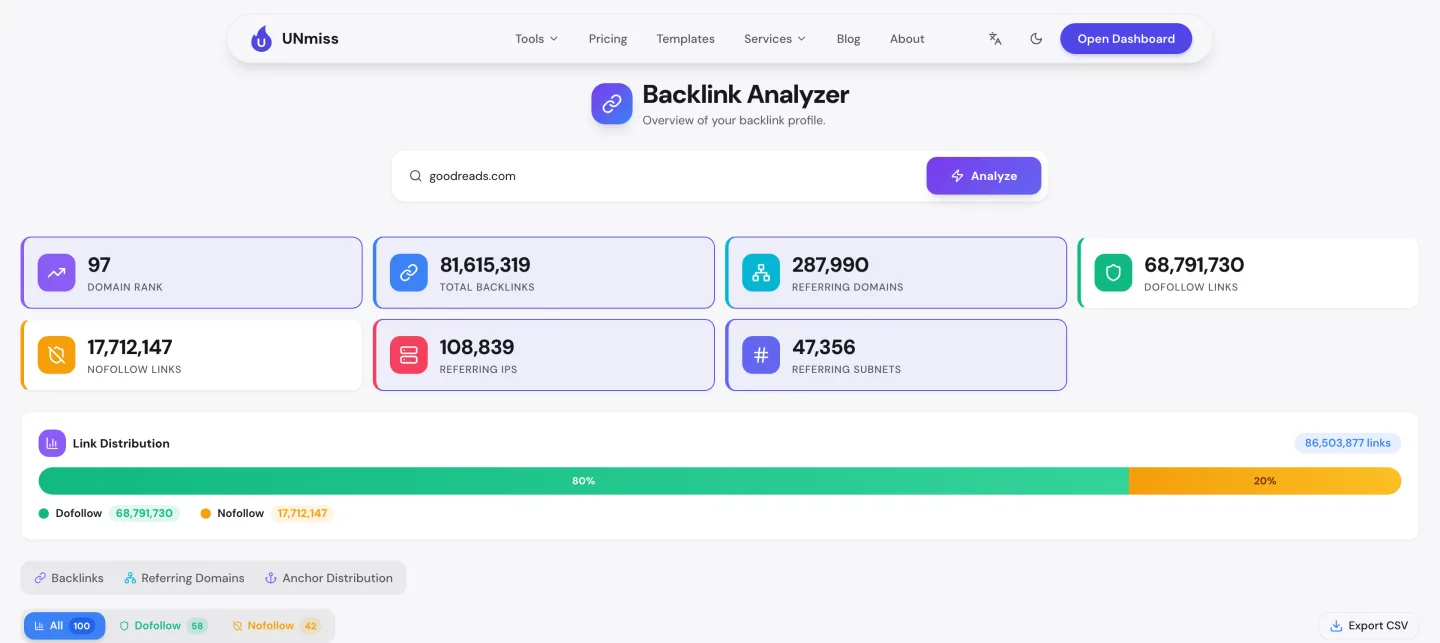
Такий ранг мають лише 2 інші поміряні нами сайти.
Дата тут стоїть свідомо. Коли я спробував оновити перевірку, інструмент віддав «Daily backlink check limit reached», тож замість видавати застарілу цифру за актуальну, серпневий замір наведено разом із його датою.
Заведіть таку саму звичку, бо кількість зворотних посилань, це знімок рухомої речі. RTINGS, поміряний у цій серії двічі з інтервалом у 2 тижні, зрушив на 43 тис. посилань.
Ставте дату біля кожної цифри, яку публікуєте чи подаєте у внутрішніх звітах. Це нічого не коштує і рятує від ситуації, коли через рік вам цитують вашу ж цифру так, ніби вона й досі правдива.
Найбільша сторінка Goodreads, це 3% його трафіку. У chess.com, 58%. Один із цих сайтів переживе втрату позиції, а другий ні. Organic Traffic Checker віддає таблицю топових сторінок для будь-якого домену, з часткою, яку бере кожна сторінка.
- Той самий звіт, який не знайшов у Goodreads жодної сторінки понад 3%
- Частка трафіку, топове ключове слово і позиція для кожної сторінки
- 3 перевірки на день, без реєстрації і без картки
Чого не скопіювати
А ось те, чого я не зміг поміряти або мусив застерегти. Кілька інструментів, які я називаю нижче, наші партнери: якщо ви купите за цими посиланнями, ми отримаємо комісію, а ви не заплатите ні цента більше.
Цифри зворотних посилань у цій статті, це 23 серпня 2026 року, а не цей запуск. Коли я спробував їх оновити, інструмент віддав «Daily backlink check limit reached», тож вони наведені з власною датою, а не подані як актуальні. Усе інше, трафік, ключові слова, вартість трафіку і аудит, поміряно 5 вересня 2026 року.
Наші цифри трафіку стосуються лише США і змодельовані з позицій і обсягів пошуку, а не пораховані. У Goodreads велика міжнародна аудиторія, тож світова цифра відчутно вища за 11,1 млн. Дані про ключові слова і посилання під цим беруться з SE Ranking, а вартість трафіку в $2,4 млн, це еквівалент витрат на рекламу, а не виручка, бо Goodreads монетизується через рекламу і роздріб материнської компанії, і жодного з цих каналів наші інструменти не бачать.
Опис архіву цитат зроблено з читання сторінок, а не з обходу, тож масштаб тут ілюстративний, а не порахований. Я зафіксував 3-4 теги на цитату і сотні тисяч сторінок тегів. Keyword Research я не запускав: у ньому є відкритий дефект, через який він віддає неправдоподібні обсяги.
А чого не скопіювати: бути тим місцем, де читачі вже ведуть облік своїх книжок. Архів цитат, теги і списки, усе це створили користувачі, і воно існує тому, що мільйони людей уже користувалися Goodreads, щоб стежити за своїм читанням. Механізм тегування скопіювати можна, потік авторів, ні.
Часті запитання
Скільки пошукового трафіку отримує Goodreads?
Близько 11,1 млн оцінених органічних візитів зі США на місяць із 11,1 млн ранжованих ключових слів при середній позиції 37, поміряно 5 вересня 2026 року, тобто приблизно 1 візит на одне ранжоване ключове слово. Наш Domain Overview оцінює це в $2,4 млн на місяць як еквівалент витрат на рекламу.
Яка сторінка Goodreads отримує найбільше трафіку?
Головна, приблизно 300 тис. візитів, це лише 3% сайту. Індекс цитат другий із 0,9% і стоїть на 2 місці за голим словом «quotes», а далі йдуть сторінки окремих книжок приблизно по 0,4% кожна.
Чи ранжуються сторінки окремих книжок?
Так, і це незвично. 2 з них у топ-5 сайту: What Is the What із приблизно 48 тис. візитів на 1 місці і To Kill a Mockingbird із 41 тис. на 2 місці. Вони працюють, бо назви книжок люди вже шукають, на відміну від нікнеймів чи назв пакетів, які в цій серії не ранжуються ніде.
Який профіль посилань у Goodreads?
Станом на 23 серпня 2026 року наш Backlink Analyzer поміряв Domain Rank 97, 290 тис. доменів-донорів, 69 млн dofollow і 18 млн nofollow-посилань, 110 тис. IP-донорів і 47 тис. підмереж. Оновити замір для цієї статті завадив денний ліміт перевірок, тож ці цифри наведено з їхньою початковою датою.
Як працюють сторінки цитат у Goodreads?
Кожна цитата несе 3 або 4 теги, і кожен тег, це посилання на сторінку, що збирає інші цитати на цю тему. Так виникає великий граф внутрішніх посилань і набір сторінок категорій із метаданих, які автори додають зі своїх власних міркувань, а не із запланованої таксономії.
Goodreads набуває чи втрачає ключові слова?
Загалом втрачає. Він набув 580 тис. ключових слів і втратив 620 тис., тобто чистий мінус приблизно 47 тис. на базі в 11,1 млн, при цьому 350 тис. піднялися проти 270 тис. тих, що просіли, тож сторінки, які лишаються, міцнішають.
Яка оцінка аудиту сайту в Goodreads?
74 зі 100, 1 критична проблема, 4 попередження, 2 зауваження і 112 пройдених перевірок на головній сторінці, це спільне останнє місце в серії разом із Healthline і freeCodeCamp, і це на сайті з 11,1 млн візитів на місяць.
Яка брендова частка пошуку в Goodreads?
29% трафіку на вибірці зі 100 ключових слів. Це ставить його між сайтами чистого відкриття, як-от Dribbble з 1%, і залежними від бренду, як-от chess.com із 92%: справжній бренд, більшість трафіку якого досі приходить на назви книжок і загальні запити.
Одна цифра, яку варто запам’ятати
3%.
Стільки становить найбільша сторінка Goodreads у частці власного трафіку, і саме ця цифра робить сайт на 11 млн візитів по-справжньому важким для підриву.
Тут немає сторінки, яку можна втратити. Жодна зміна позицій не забирає помітного шматка. Трафік розмазаний по мільйонах сторінок книжок, цитат і тегів, кожна дає цівку, кожна відповідає на запит, який хтось набирає з причин, що не зміняться.
Порівняйте з chess.com, де 58% приходить на одну URL, або з Open Library із 48%. Це більші поодинокі перемоги і значно коротший шлях до падіння.
Тож запустіть звіт топових сторінок на власному домені і подивіться на перший рядок як на відсоток, а не як на число. Якщо він вище 20%, ваша наступна робота, це не ще більше того, що вже виграє, а та неефектна широта, від якої ті 20% перестануть мати значення.
Знайшли у власному звіті щось несподіване або міряєте це інакше? Мені справді цікаво: усі використані інструменти безкоштовні, тож кожну цифру можна перевірити самостійно. Трафік, ключові слова, вартість трафіку і аудит поміряно 5 вересня 2026 року, а цифри зворотних посилань, від 23 серпня 2026 року, і в тексті вони так і датовані. Усе це безкоштовні запуски наших власних інструментів, у межах США і змодельовані, а не пораховані там, де інструмент про це каже. Даних про виручку Goodreads у нас не було.