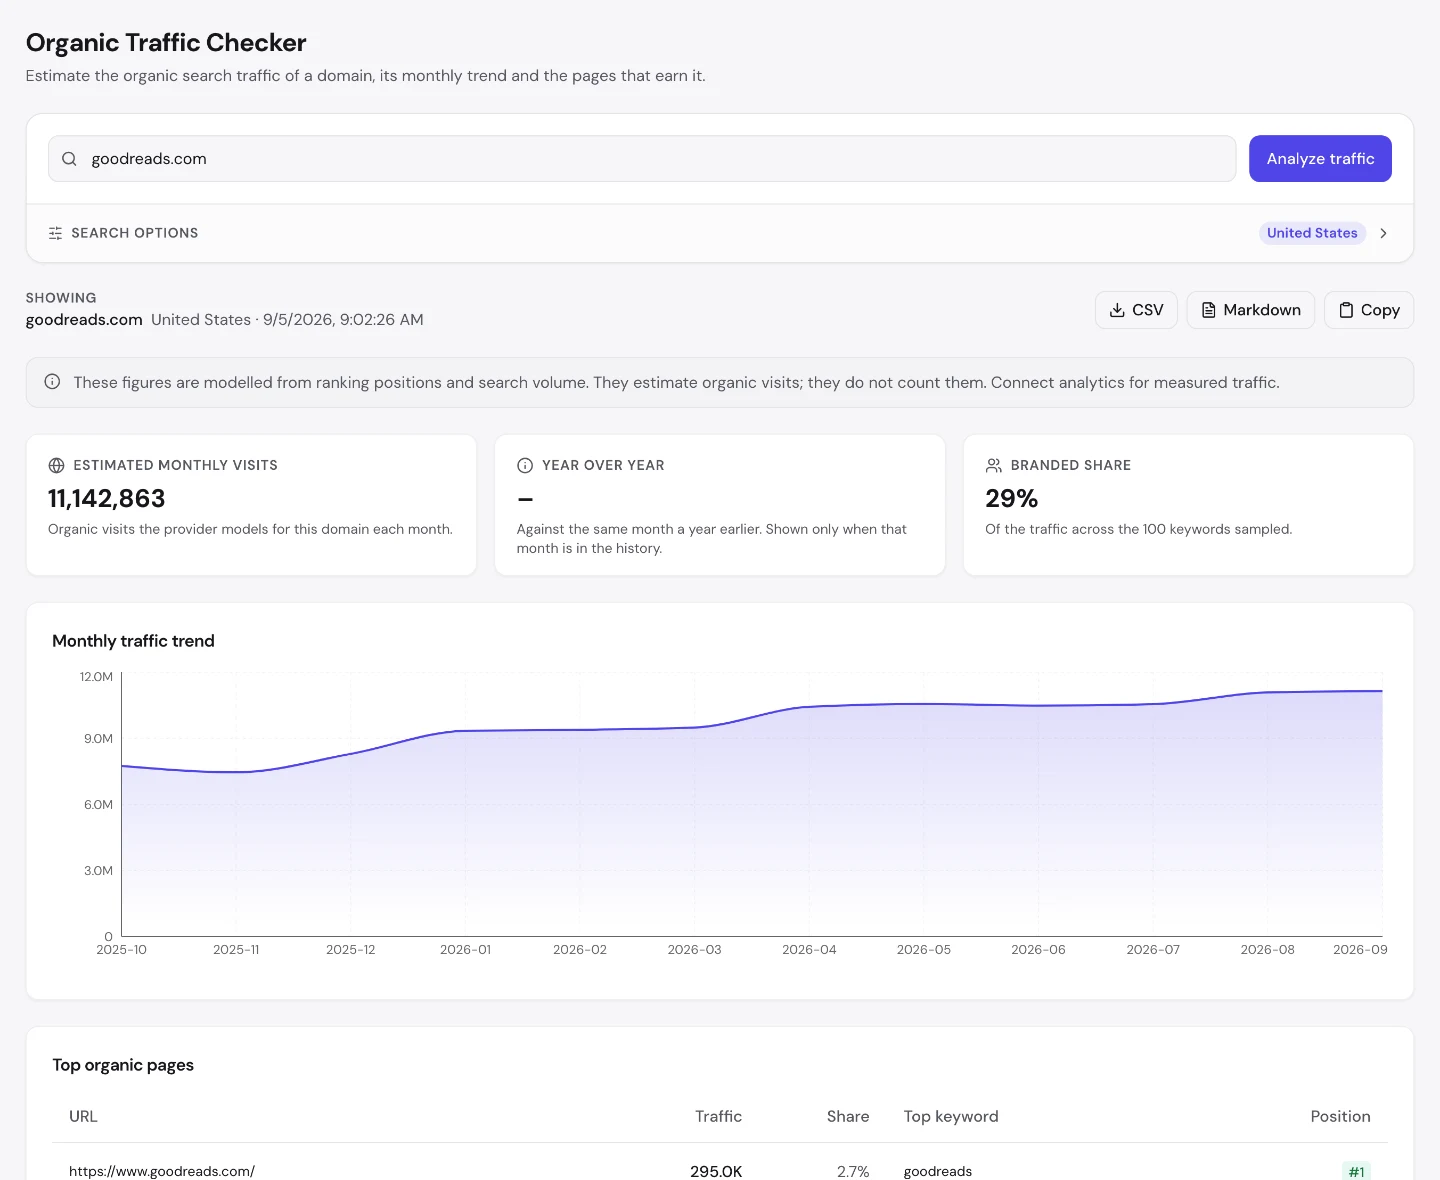
Goodreads ранжируется по 11.1M ключевых слов и получает 11.1M визитов, почти ровно по одному визиту на ключевое слово.
Ни одна страница не несёт даже 3% этого. Главная забирает 3%, а всё, что идёт после неё, ниже 1%.
Я прогнал goodreads.com через 4 наших инструмента. Это самый ровный крупный сайт в серии, его отдельные страницы книг реально ранжируются, чего почти не делает ни одна страница-сущность на этих 19 сайтах, а страницы цитат у него занимаются тем, чего никто не планирует. Вот 8 уроков.
Читайте свою концентрацию как меру риска
Инструмент Organic Traffic Checker оценивает Goodreads примерно в 11.1M визитов в месяц, при том что главная забирает всего 3%. Всё, что идёт после неё, ниже 1%.
Бесплатно, и форму трафика видно сразу. Чтобы найти тип страниц, который никто не планировал, нужна полная выгрузка всего, по чему вы ранжируетесь, а это как раз то, что Semrush и SE Ranking делают действительно хорошо.
Ровнее только Healthline и NHS.uk, и у обоих то же структурное преимущество, которое у вас может быть, а может и не быть: огромный набор мелких постоянных запросов, где ничто не доминирует.
А теперь сравните с chess.com, у которого главная даёт 58% трафика. Оба сайта каталожные. Один переживёт потерю позиции, другой нет.
Поэтому читайте собственную концентрацию как меру риска, а не как повод для гордости. Откройте отчёт по лучшим страницам и сложите первые три строки. Если вместе они дают больше половины трафика, вы в одном апдейте алгоритма от плохого квартала, и об этом лучше знать заранее, а не постфактум.
Проверьте 20 названий сущностей, прежде чем генерировать хоть одну
Вот важный урок, и он закрывает спор, который тянется через всю серию.
To Kill a Mockingbird стоит 2-й. What Is the What стоит 1-й. Отдельные страницы-сущности, и это в топ-5 сайта, который получает 11M визитов.
На 19 сайтах страницы-сущности почти никогда не срабатывали. У PyPI ничего не приносят страницы пакетов. У chess.com ничего не приносят профили игроков. У freeCodeCamp ничего не приносят страницы авторов.
Единственные исключения, это книги Goodreads и ClinicalTrials.gov с его карточками исследований, и работают оба по одной причине. Название книги, это то, что люди и так ищут. Никнейм и имя пакета, нет.
Поэтому проведите тест до того, как возьмётесь за дело: он занимает 5 минут и сэкономит вам квартал. Возьмите 20 названий сущностей из собственной базы и загоните их в Keyword Research.
Если у большинства частотность окажется нулевой, вы собираетесь генерировать склад. Никакие правки шаблона этого не исправят, а вы потратите год, гадая, почему страницы так и не взлетели.
Ищите слой, который никто не проектировал
Вторая по величине страница Goodreads, это /quotes, и она стоит 2-й по голому слову «quotes».
Не «book quotes». Не «literary quotes». Одно общее слово, одно из самых высокочастотных в интернете, и держит его книжный сайт.
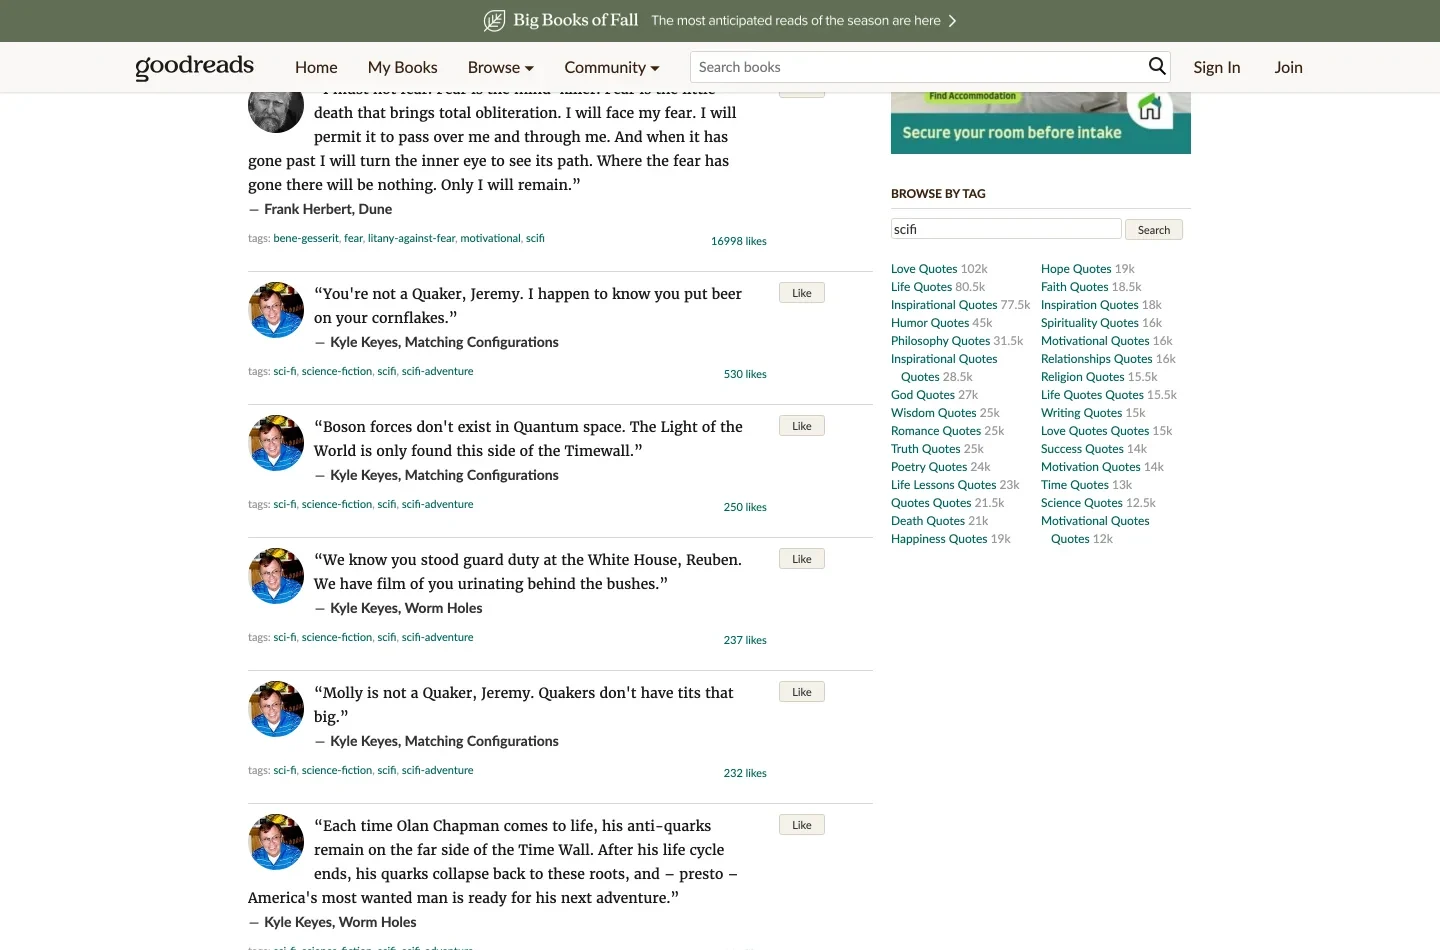
За ней стоит огромный архив цитат, где у каждой записи есть теги, ведущие на новые страницы цитат. Это агрегирующий слой, не имеющий никакого отношения к рецензиям на книги.
Вот шаблон, который серия выдаёт снова и снова: слой, который никто не стал бы вписывать в продуктовые требования, и есть тот слой, который ранжируется. itch.io с каталогами тегов, Eventbrite со страницами навигации, Dribbble с архивами тегов, TED с годовыми корзинами, теперь цитаты Goodreads.
Поэтому пойдите и посмотрите, что ваш сайт порождает побочно: фильтры, архивы, страницы-побочные продукты, за которые никто не отвечает. Одна из них, скорее всего, ближе к высокочастотному запросу, чем всё, что стоит у вас в планах, и никто этого не заметил, потому что это никогда не было ничьим проектом.
Размечайте тегами каждую цитату, которую публикуете
Вот копируемый механизм, и он дешёвый.
У каждой цитаты Goodreads 3 или 4 тега, и каждый тег ведёт на страницу с другими цитатами по этой теме. В одной только подборке цитат о любви больше 100K записей.
Так архив сам строит собственный граф внутренних ссылок и собственные категорийные страницы из метаданных, которые участники добавляют по своим причинам. Никто не планировал таксономию под ключевые слова.
Это можно скопировать на любом контенте, у которого есть естественные признаки. Дайте людям ставить теги, любой тег, перешагнувший порог, превращайте в индексируемую страницу, и пусть таксономия растёт сама.
Единственная дисциплина, которая здесь нужна, это порог. Проверьте, у каких тегов есть реальный спрос, в Keyword Cluster, прежде чем их индексировать, иначе вы опубликуете тысячи страниц с 2 элементами на каждой и сведёте всю пользу на нет.
Goodreads получает большую долю трафика со страниц цитат, которые никто не задумывал как канал роста. У большинства сайтов такой слой тоже есть. Найти его, это неделя анализа, а не год догадок.
- Находим тип страниц, который уже тихо работает
- Разворачиваем его как следует и в масштабе
- SEO и GEO, чтобы удержать результат
- Бесплатная консультация, без обязательств
Рассчитывайте на ручеёк с каждой страницы
По данным отчёта Domain Overview: 11.1M органических ключевых слов против 11.1M визитов, при средней позиции 37.
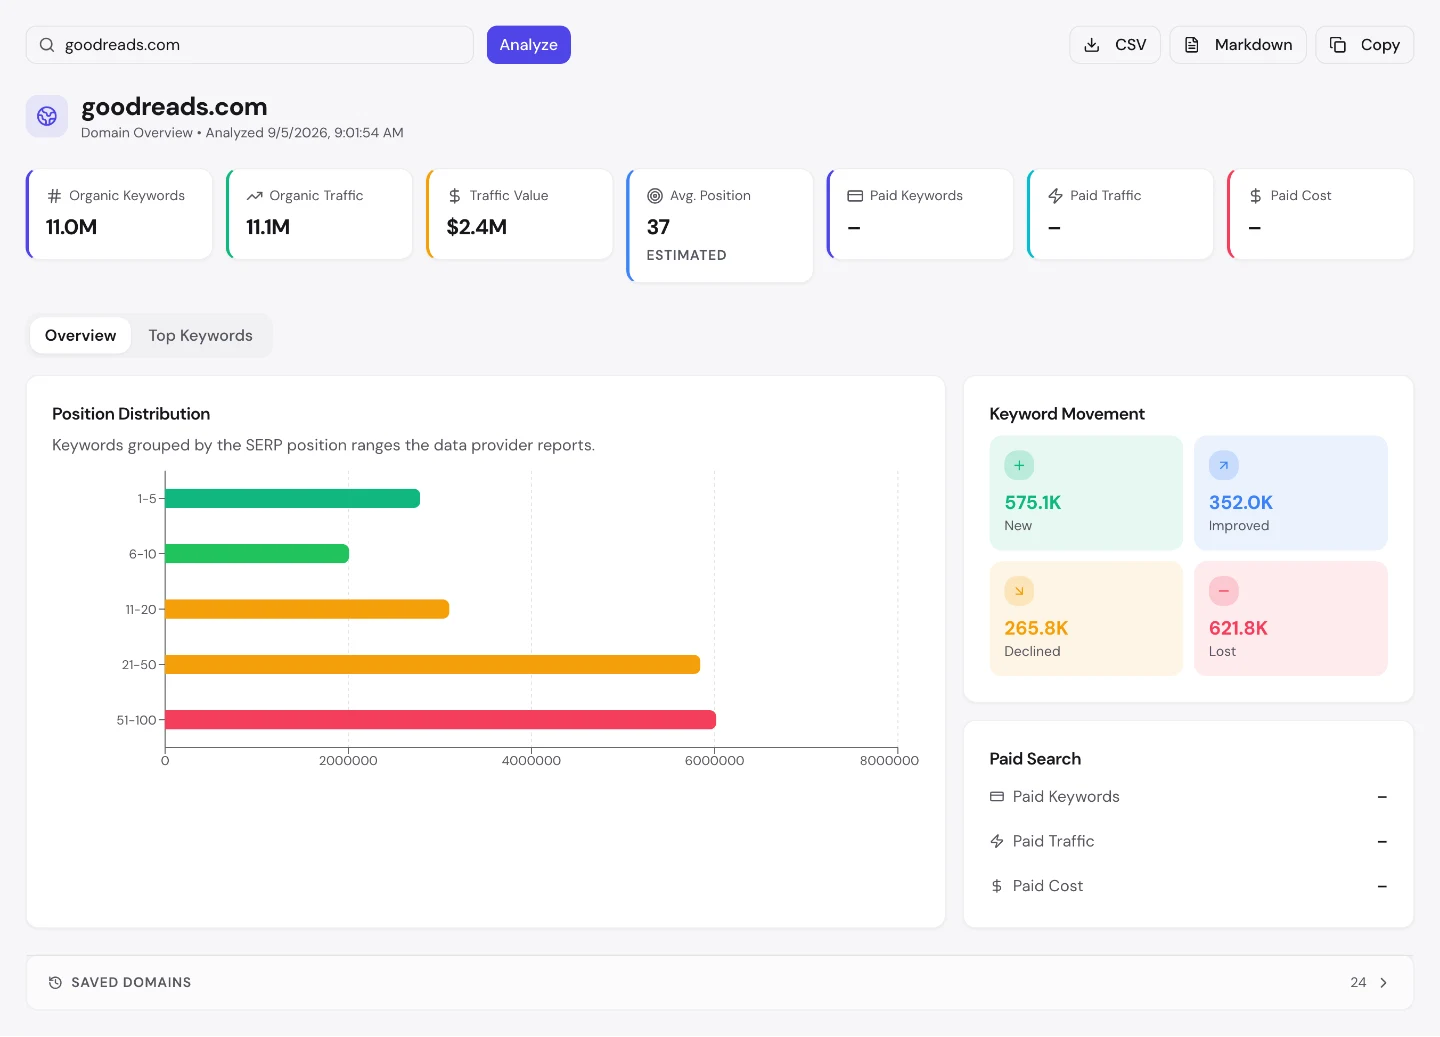
Один визит на ранжирующееся ключевое слово. Это точно описывает форму: миллионы страниц, каждая ранжируется по горстке запросов и приносит ручеёк.
Позиция 37, это второй результат в серии, и для каталога такого размера это высоко, потому что названия книг достаточно конкретны, чтобы выигрывать начисто.
Если вы ведёте что-то похожее, настройте ожидания на ручеёк со страницы и планируйте объём соответственно. Страница, которая приносит 3 визита в месяц, в этой модели не провал, это единица измерения. Важно другое: сможете ли вы делать их дёшево и в достаточном количестве и ищет ли кто-нибудь то, чему каждая из них посвящена.
Следите за колонкой потерь, а не за общим числом
Он теряет больше ключевых слов, чем набирает, при этом улучшая качество: третий каталог в серии, который сжимается, хотя записи добавляет.
Книги не устаревают так, как события или пакеты, поэтому текучка здесь, скорее всего, это редкие издания и дубли записей, выпадающие из индекса, а не что-то про релевантность. У вашего каталога найдётся свой эквивалент: записи, по которым вы не стали бы скучать, тихо уходящие.
Именно поэтому смотреть надо на колонку потерь каждый месяц, а не на общее число. На базе в 11M ключевых слов потеря 620K растворяется внутри заголовка, который по-прежнему читается как «11 миллионов», и вы можете сжиматься целый год, а цифра в вашем отчёте так и не сдвинется.
Чините критическое, не смотрите на оценку
Инструмент Website Audit ставит главной странице 74/100, и 1 критическая проблема осталась нерешённой.
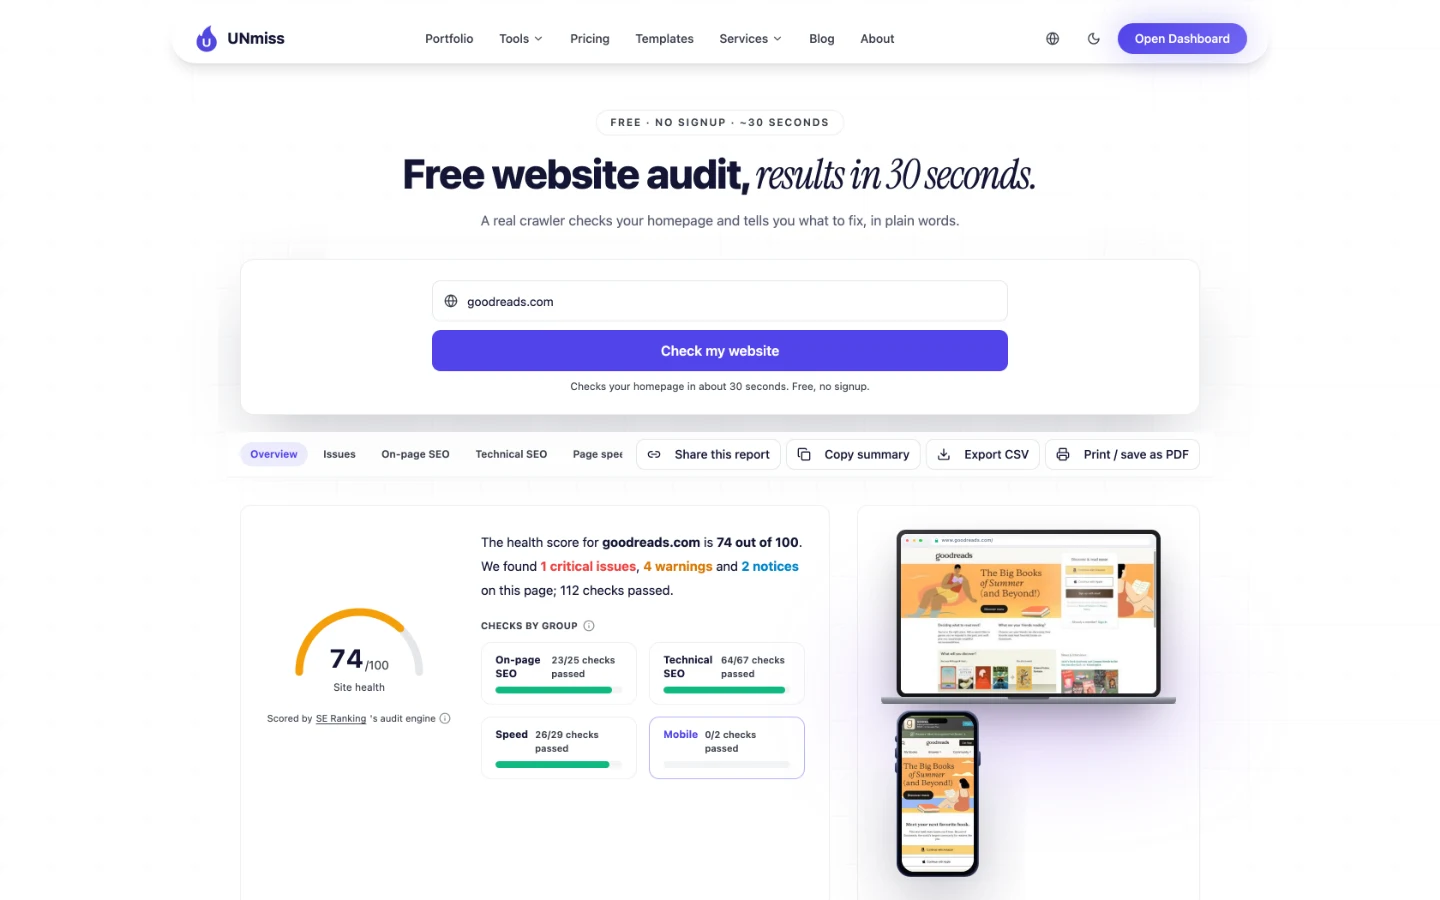
Худший результат в серии, разделённый с двумя другими сайтами, и это на сайте с 11.1M визитов в месяц.
При этом у Dribbble и ClinicalTrials.gov ровно по 100, и оба сжимаются. 19 сайтов спустя оценка аудита не предсказала ничего.
Поэтому чините критические проблемы, они конкретные и дешёвые, а потом перестаньте смотреть на общую цифру. Если оценка низкая, а с трафиком всё в порядке, беды у вас нет. Если она идеальная, а трафик стоит на месте, оценка всё равно не собиралась объяснять вам почему.
Ставьте дату у каждой цифры по ссылкам
На 23 августа 2026 года наш Backlink Analyzer намерил у Goodreads Domain Rank 97, при 290K ссылающихся доменов. Это один из самых сильных профилей во всей этой работе.
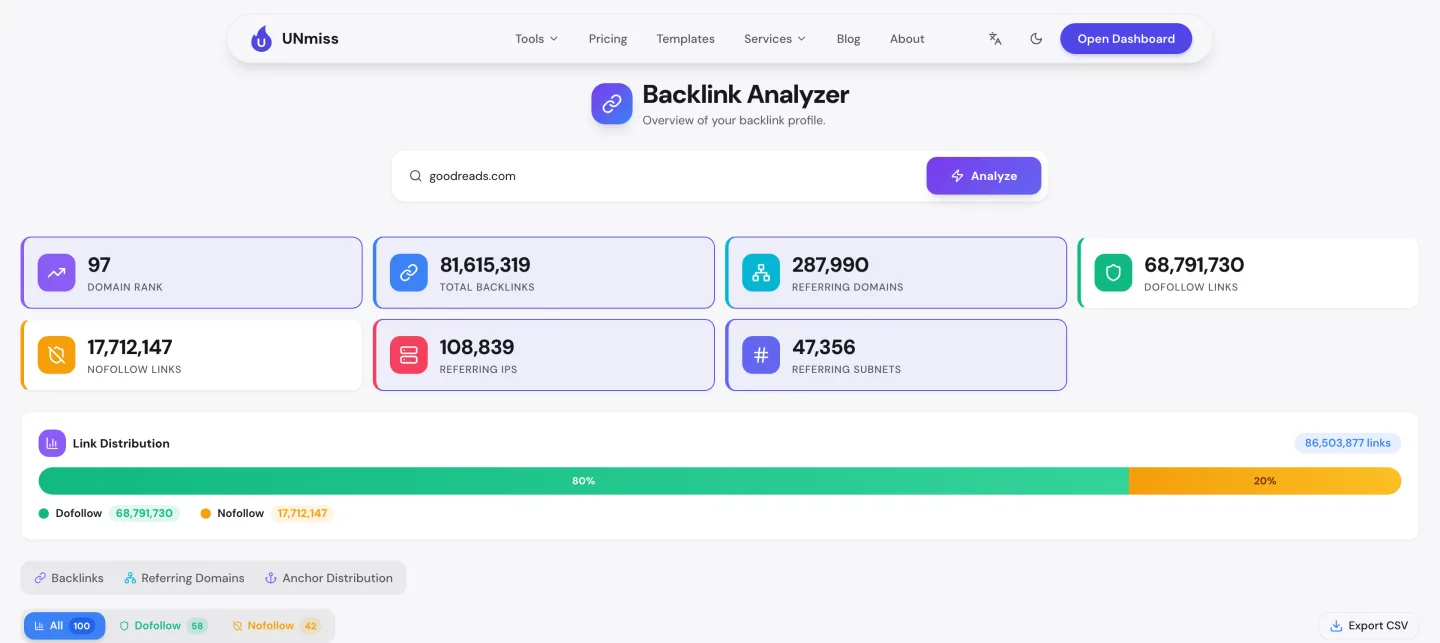
Такому рангу соответствуют только 2 других измеренных нами сайта.
Дата стоит там намеренно. Когда я попробовал обновить проверку, инструмент вернул «Daily backlink check limit reached», и вместо того чтобы выдать устаревшую цифру за свежую, августовский замер приводится вместе с его датой.
Заведите ту же привычку, потому что число ссылок, это снимок движущейся вещи. RTINGS, замеренный в этой серии дважды с разницей в 2 недели, сдвинулся на 43K ссылок.
Ставьте дату рядом с каждой цифрой, которую публикуете или показываете внутри компании. Это ничего вам не стоит и не даёт кому-нибудь через год процитировать ваше число так, будто оно всё ещё верно.
Крупнейшая страница Goodreads, это 3% его трафика. У chess.com, 58%. Один из этих сайтов переживёт потерю позиции, другой нет. Organic Traffic Checker возвращает таблицу лучших страниц по любому домену, с долей, которую забирает каждая.
- Тот самый отчёт, который не нашёл у Goodreads ни одной страницы выше 3%
- Доля трафика, главный запрос и позиция по каждой странице
- 3 проверки в день, без регистрации и карты
Чего скопировать нельзя
А вот то, что я измерить не смог или обязан оговорить. Пара инструментов, которые я называю ниже, наши партнёры: если вы покупаете по этим ссылкам, мы получаем комиссию, а вы не платите ни цента больше.
Цифры по ссылкам в этой статье относятся к 23 августа 2026 года, а не к этому прогону. Когда я попробовал их обновить, инструмент вернул «Daily backlink check limit reached», поэтому они приводятся с их датой, а не подаются как актуальные. Всё остальное (трафик, ключевые слова, ценность трафика, аудит) измерено 5 сентября 2026 года.
Наши цифры по трафику относятся только к США и смоделированы по позициям и частотности, а не посчитаны напрямую. У Goodreads большая международная аудитория, поэтому мировое число заметно выше этих 11.1M. Данные по ключевым словам и ссылкам под всем этим берутся из SE Ranking, а ценность трафика в $2.4M, это эквивалент рекламных расходов, а не выручка: Goodreads зарабатывает на рекламе и на рознице материнской компании, и ни того ни другого наши инструменты не видят.
Описание архива цитат сделано по чтению страниц, а не по обходу, поэтому масштаб считайте иллюстративным, а не посчитанным. Зафиксировано от 3 до 4 тегов на цитату и страницы тегов, которых сотни тысяч. Keyword Research я не запускал: у него открытый дефект с неправдоподобной частотностью.
И вот чего скопировать нельзя: быть тем местом, где читатели уже ведут учёт своих книг. Архив цитат, теги и списки, всё это создали пользователи, и существует оно потому, что миллионы людей уже вели в Goodreads свой список чтения. Механизм тегирования копируется, поток участников, нет.
Частые вопросы
Сколько поискового трафика получает Goodreads?
Около 11.1M органических визитов из США в месяц по оценке, с 11.1M ранжирующихся ключевых слов при средней позиции 37, замер от 5 сентября 2026 года, то есть примерно по одному визиту на ключевое слово. Наш Domain Overview оценивает это в $2.4M в месяц в пересчёте на рекламный бюджет.
Какая страница Goodreads получает больше всего трафика?
Главная, примерно 300K визитов, и это всего 3% сайта. Второй идёт индекс цитат с 0.9%, который стоит 2-м по голому слову «quotes», а за ним страницы отдельных книг примерно по 0.4% каждая.
Ранжируются ли страницы отдельных книг?
Да, и это необычно. Две из них стоят в топ-5 сайта: What Is the What примерно с 48K визитов на 1-м месте и To Kill a Mockingbird с 41K на 2-м. Работают они потому, что названия книг, это то, что люди и так ищут, в отличие от никнеймов и имён пакетов, которые во всей серии не ранжируются нигде.
Какой у Goodreads ссылочный профиль?
На 23 августа 2026 года наш Backlink Analyzer намерил Domain Rank 97, 290K ссылающихся доменов, 69M dofollow и 18M nofollow ссылок, 110K ссылающихся IP и 47K подсетей. Обновить данные для этой статьи помешал дневной лимит проверок, поэтому цифры приводятся с их исходной датой.
Как работают страницы цитат Goodreads?
У каждой цитаты 3 или 4 тега, и каждый тег, это ссылка на страницу, собирающую другие цитаты по этой теме. Так получается большой граф внутренних ссылок и набор категорийных страниц из метаданных, которые участники добавляют по своим причинам, а не из спланированной таксономии.
Goodreads набирает ключевые слова или теряет?
В итоге теряет. Он набрал 580K ключевых слов и потерял 620K, то есть чистый минус около 47K на базе в 11.1M, при этом 350K подросли против 270K просевших, так что выжившие страницы усиливаются.
Какая у Goodreads оценка аудита сайта?
74 из 100, при 1 критической проблеме, 4 предупреждениях, 2 замечаниях и 112 пройденных проверках на главной, это худший результат в серии наравне с Healthline и freeCodeCamp, и это на сайте с 11.1M визитов в месяц.
Какая у Goodreads доля брендового поиска?
29% трафика по 100 ключевым словам из выборки. Это ставит его между сайтами чистого обнаружения вроде Dribbble с 1% и зависимыми от бренда вроде chess.com с 92%: настоящий бренд, у которого большая часть трафика всё же приходит по названиям книг и общим словам.
Одно число, которое стоит запомнить
3%.
Столько даёт крупнейшая страница Goodreads в доле его собственного трафика, и именно это число делает сайт с 11M визитов по-настоящему трудным для подрыва.
Здесь нечего терять. Никакая смена позиций не отнимает заметный кусок. Трафик размазан по миллионам страниц книг, цитат и тегов, каждая приносит ручеёк и отвечает на запрос, который кто-то вводит по причинам, которые не изменятся.
Сравните с chess.com, где 58% приходит на один URL, или с Open Library с его 48%. Это более крупные отдельные победы и куда более короткие падения.
Поэтому прогоните отчёт по лучшим страницам на собственном домене и посмотрите на первую строчку как на процент, а не как на число. Если он выше 20%, ваша следующая работа, это не ещё больше того, что уже побеждает, а та самая негламурная широта, после которой эти 20% перестают иметь значение.
Нашли в собственном отчёте что-то неожиданное или считаете иначе? Мне правда интересно узнать: все использованные инструменты бесплатны, так что каждую цифру можно перепроверить самому. Трафик, ключевые слова, ценность трафика и аудит измерены 5 сентября 2026 года, а цифры по ссылкам относятся к 23 августа 2026 года и так и датированы в тексте. Всё это бесплатные прогоны наших собственных инструментов, охват США, смоделированные, а не посчитанные, там где инструмент об этом говорит. Данных о выручке Goodreads у нас не было.