PyPI публикует 2M страниц и получает 154K поисковых визитов в месяц.
Это 1 визит на 13 страниц. GeeksforGeeks получает в 20 раз больше трафика с малой доли этих URL.
Я прогнал pypi.org через 4 наших инструмента, ожидая обычной истории про программатик-SEO (массовую генерацию страниц по шаблону), и получил обратное: самое большое число страниц в этой подборке при самом маленьком трафике. Плюс самый чистый технический аудит, который я вообще измерял. Вот 8 уроков, и большая часть из них про то, чего делать не надо.
Никогда не считайте страницы входным параметром
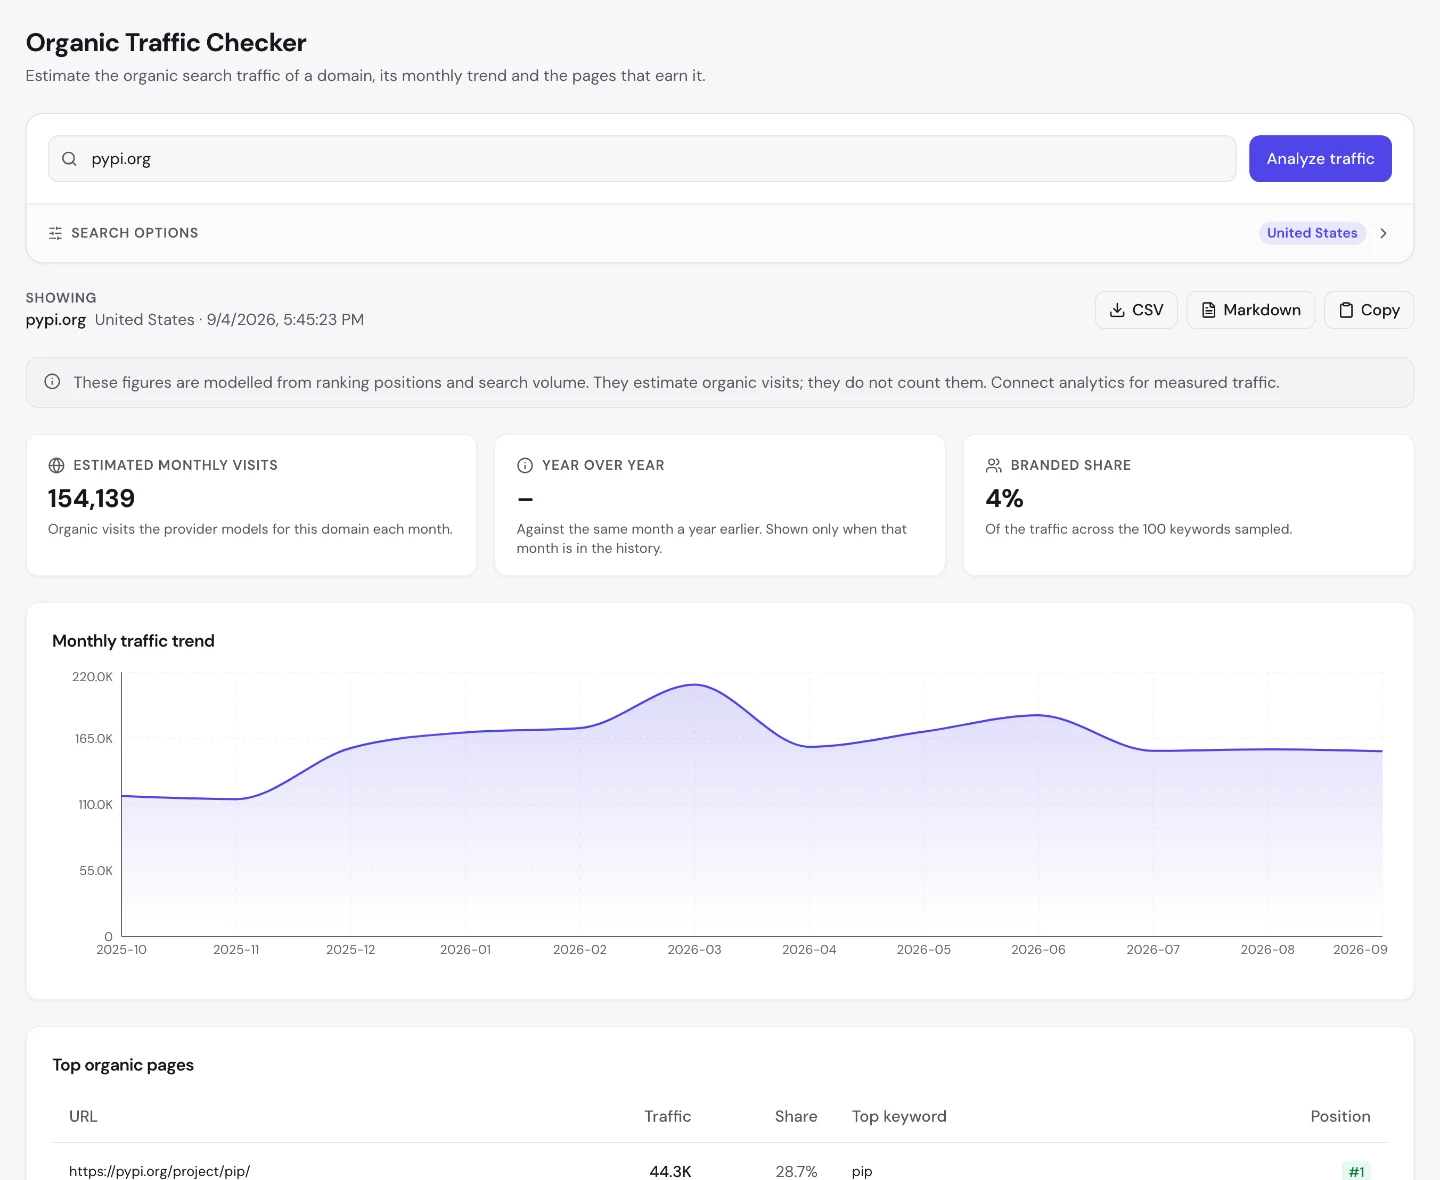
Более ранний обход собственной карты сайта PyPI насчитал 2M URL. Инструмент Organic Traffic Checker оценивает сайт в 154K расчётных визитов в месяц, а Domain Overview показывает четверть миллиона ранжирующихся ключевых слов.
Бесплатно, и соотношение видно сразу. Прежде чем запускать тип страниц, проверьте частотность 20 реальных названий сущностей в Semrush или SE Ranking. Это полдня работы, и это решает, стоит ли вообще начинать проект.
Healthline выдаёт в 60 раз больше ключевых слов с малой доли страниц.
Число страниц, это не входной параметр трафика. Это входной параметр права на участие в трафике, а право на участие ничего не стоит, если то, что на странице, никто не ищет.
Приложите это к любому своему плану, который начинается со слов «сделаем страницу под каждую…». План плох не потому, что он программатик, а потому, что никто не проверил, ищут ли эти сущности, и такая проверка занимает полдня, а сборка занимает квартал.
Назовите запрос, который выигрывает каждый тип страниц
Тот же обход разделил хозяйство по форме: больше половины опубликованных страниц PyPI, это профили пользователей, а остальное, страницы проектов.
Профиль пользователя в реестре пакетов перечисляет чьи-то пакеты и больше ничего: ни описания, ни документации, ни вопроса, который вы могли бы правдоподобно искать.
Его никто не ищет. Он не может ранжироваться ни по чему, кроме имени пользователя, а имя пользователя и так закрыто самими пакетами.
Урок прямой: публикация типа страниц, который не отвечает ни на один запрос, строит не библиотеку контента, а проблему с краулинговым бюджетом.
Поэтому, прежде чем генерировать страницу под каждую сущность, назовите поиск, который эта страница могла бы правдоподобно выиграть. Если честный ответ «никакой», ставьте noindex и держите её вне карты сайта: людям, которые пришли по ссылке, она всё равно откроется.
Проверьте, есть ли спрос в вашем хвосте
Теперь посмотрите, куда уходит тот трафик, который всё-таки приходит.
/project/pip/ забирает почти 29% всего, и занимает первое место по запросу «pip». Главная страница далеко на втором месте, дальше certifi, requests и pandas.
1 страница из 2M несёт почти треть сайта.
Сравните с Healthline, где ни одна страница не доходит до 1%. Идея та же, очень большая библиотека, а концентрация полностью противоположная, потому что страницы Healthline отвечают на вопросы, которые люди задают, а страницы PyPI в основном нет.
Длинный хвост существует, только если в хвосте есть спрос. Прогоните тот же отчёт по себе: если трафик схлопывается на 2 или 3 страницы, у вас не библиотека, у вас несколько хороших страниц и много хостинга.
Проверьте 20 названий сущностей до того, как строить
Вот глубинная причина, и о ней стоит сказать прямо.
Разработчик, которому нужен пакет на Python, не гуглит его. Имя вы уже знаете из документации, туториала или от коллеги, и вы набираете pip install thing. Страница пакета, это то, куда попадают по URL, а не результат поиска, который находят.
Ваш собственный каталог может работать ровно так же, и если так, никакая работа над страницами этого не изменит.
Исключения это подтверждают: ранжируются страницы pip, requests, pandas и certifi (горстка названий пакетов, которые стали общеупотребительными словами и которые люди действительно ищут). Ваш аналог, это те из ваших сущностей, которые кто-то назовёт коллеге, никогда о вас не слышавшему.
Поэтому, прежде чем строить программатик-тип страниц, прогоните 20 образцов названий сущностей через Keyword Research. Берите их наугад из середины списка, а не из начала: начало всегда выглядит обнадёживающе.
Если 18 вернутся пустыми, у вас нет контентной возможности. У вас есть база данных с веб-интерфейсом, вещь совершенно нормальная, пока её никто не меряет по органическому трафику.
PyPI публикует 2M страниц ради 154K визитов. Со страницами всё в порядке. Спроса там не было изначально. Мы проверяем это первым делом, чтобы бюджет на разработку уходил на те типы страниц, которые реально могут ранжироваться.
- Проверка спроса до того, как что-то сгенерировано
- Называем запрос, который выигрывает каждый тип страниц
- Техническое SEO, GEO и разработка в одной команде
- Бесплатный созвон, чтобы разобрать ваш план
Положите свою ссылку внутрь чужого шаблона
Ссылочный профиль рассказывает ту же историю с другой стороны. Наш Backlink Analyzer показывает 100K ссылающихся доменов при Domain Trust 96.
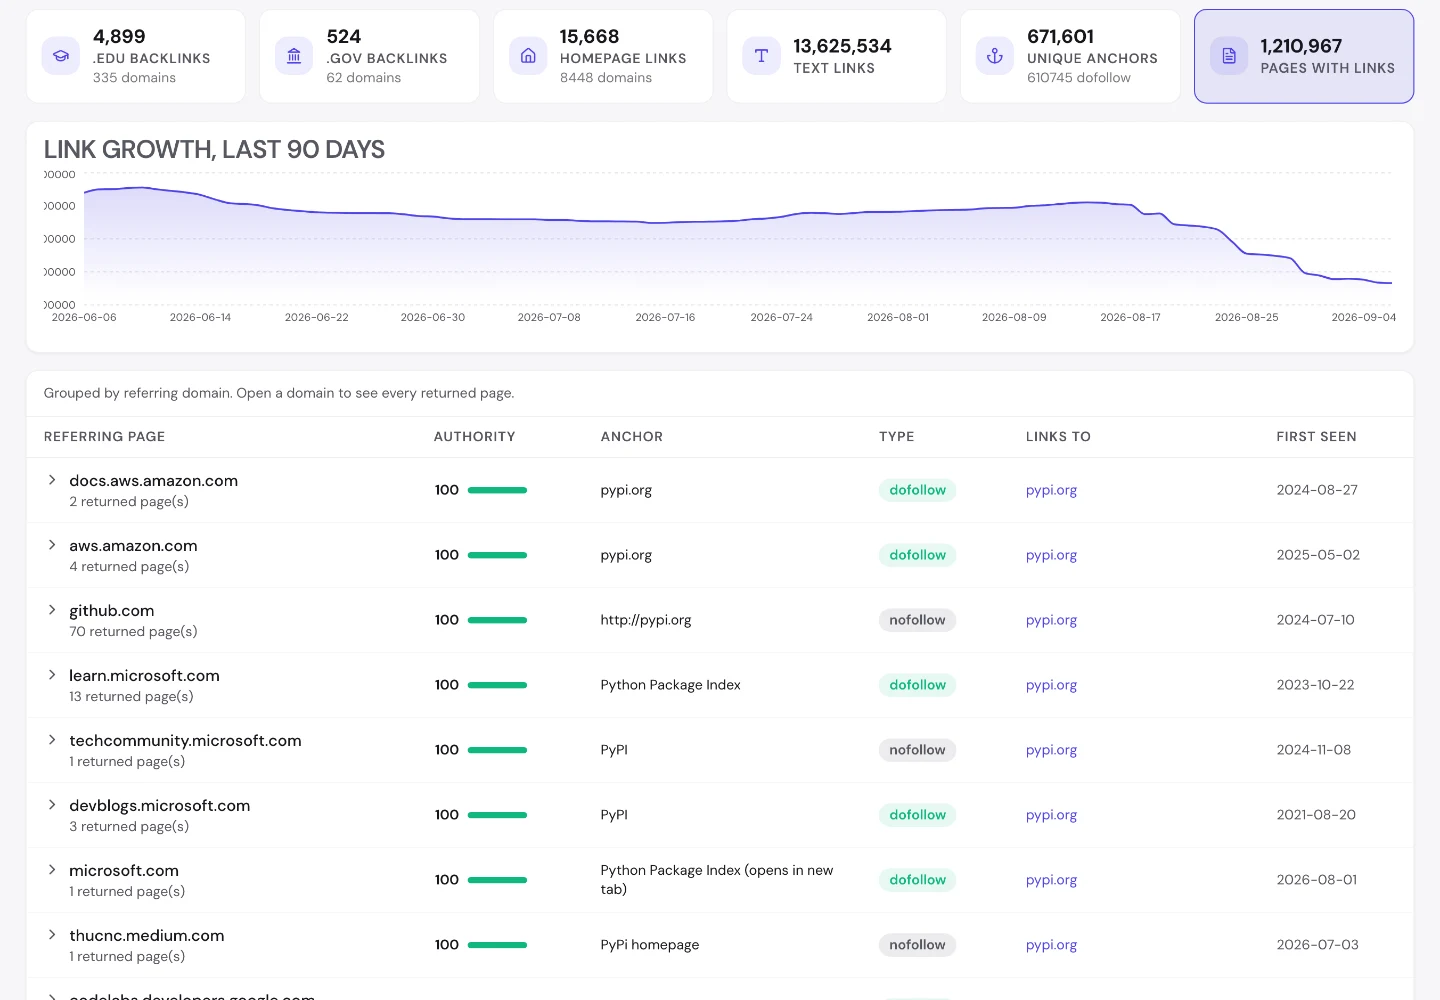
«PyPI» лидирует с четвертью профиля. Дальше идут «Python Package», «Python PyPI», «Python SDK» и «API Client (Python)» (4 почти одинаковые общие фразы, и на каждую приходится почти одно и то же число ссылок).
Такая кучность, это отпечаток сгенерированной документации. Авторы пакетов публикуют бейджи в README и шаблоны документации, которые ссылаются обратно той фразой, что была в шаблоне, и эта фраза повторяется в тысячах проектов.
Это работает, и тот же механизм используют Eventbrite и itch.io (разница в том, что версию PyPI никто не проектировал, она выросла из соглашения об упаковке, которое никто не записывал как маркетинговое решение).
А свою вы можете спроектировать нарочно. Всё, что вы даёте пользователям для встраивания, бейдж, виджет, экспорт, несёт ссылку и анкор, который вы выбираете один раз, и это будет работать ещё долго после того, как выпустившие его люди уйдут.
Перестаньте ждать, что зелёный аудит окупится
Инструмент Website Audit оценивает главную страницу на 91/100, ничего критичного и всего 1 предупреждение.
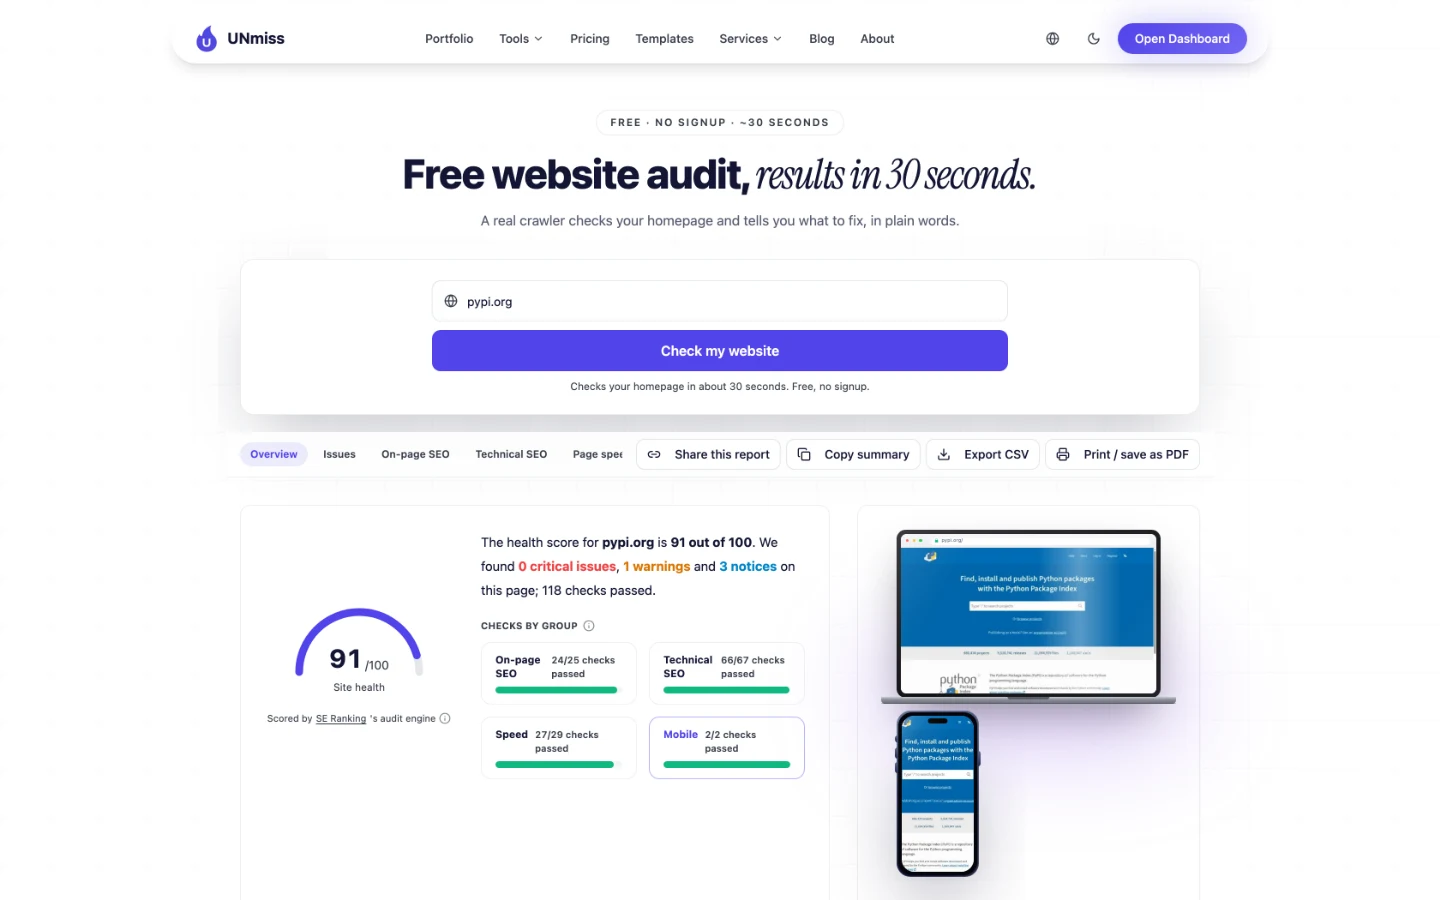
Это лучший балл и наибольшее число пройденных проверок среди 10 сайтов, замеренных в этих 2 подборках. Healthline набрал 74 при ценности трафика в 40 раз выше.
И это честный вывод всей статьи: PyPI, лучше всех здесь сделанный сайт и хуже всех работающий. Техническое качество необходимо и близко не достаточно.
Site Speed и Meta Tag Generator закроют большую часть того, что подсвечивает аудит, и ни один из них не сдвинет страницу, которую никто не ищет.
Поэтому, если аудит зелёный, а трафик стоит, перестаньте дорабатывать аудит. Он никогда не был проблемой, и ещё квартал правок даст ещё квартал того же результата.
Планируйте списание, а не только запуск
Сайт теряет больше ключевых слов, чем набирает, и просаживается по большему их числу, чем подрастает.
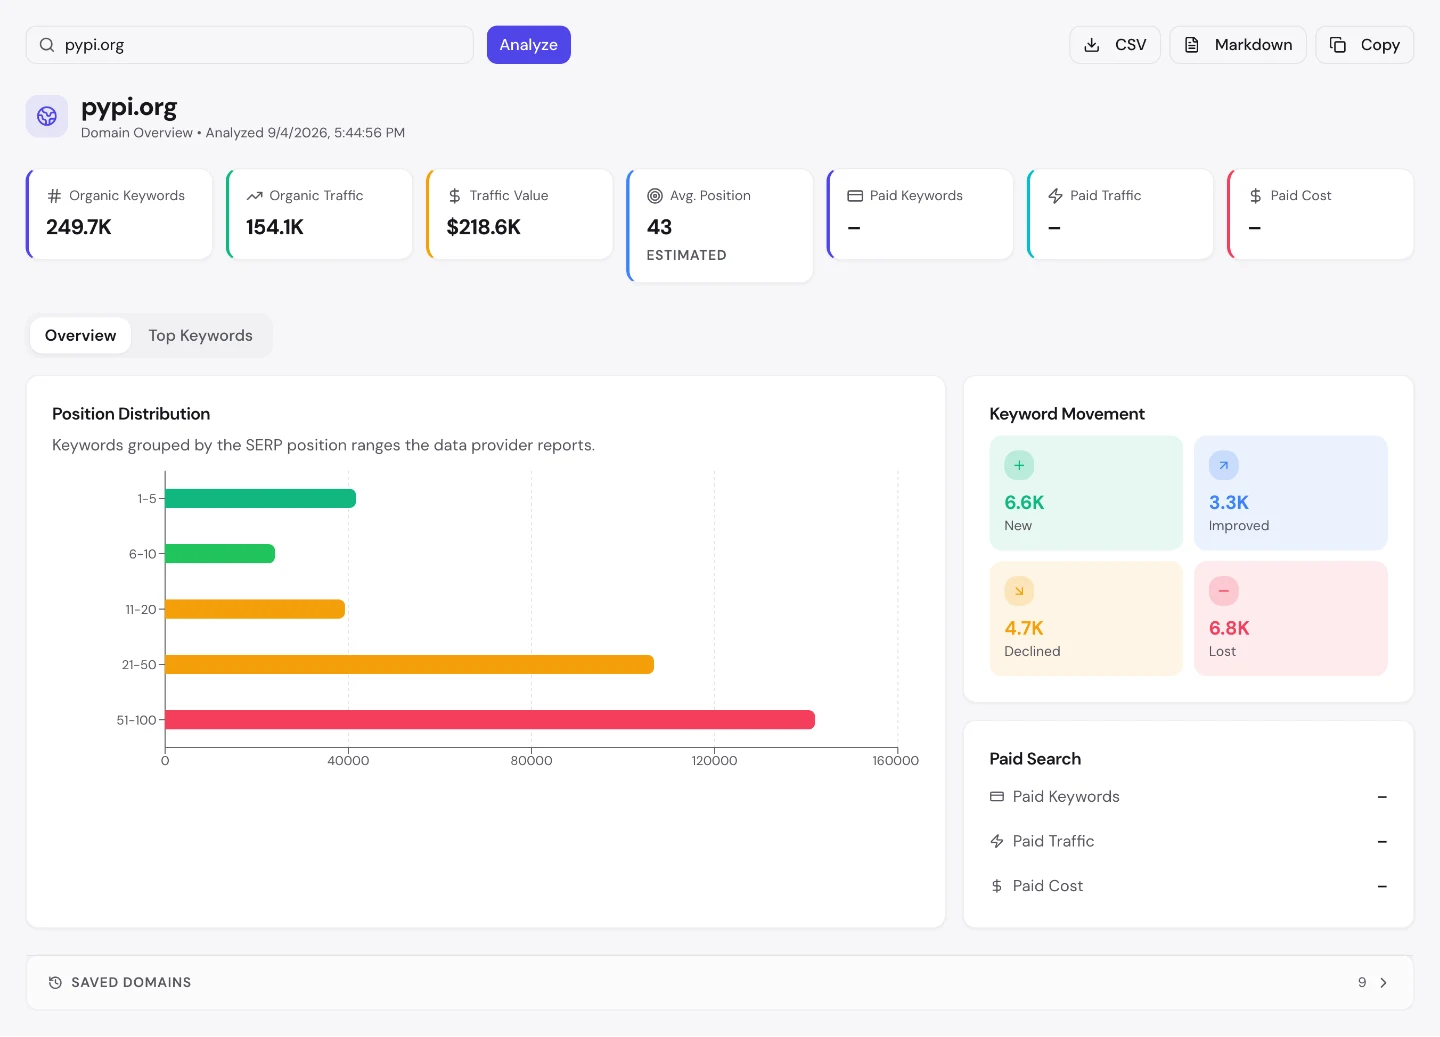
Пакеты забрасывают постоянно. У каждого мёртвого проекта остаётся страница, его перестают где-либо упоминать, и он медленно выпадает из индекса. Хозяйство растёт, а его поисковая поверхность сжимается, и ту же картину показывает GOV.UK по совершенно другой причине.
Поэтому, если вы публикуете страницу под каждую сущность, а у сущностей есть жизненный цикл, планируйте списание так же осознанно, как создание. Решите сейчас, что происходит со страницей, когда описываемое ею умирает: редирект, слияние, noindex или оставить как есть. Решить потом означает не решить никогда.
И держите выжившие запросы в Rank Tracker и смотрите на спад, пока это ещё горстка страниц, а не годовой объём.
Не индексируйте то, что не отвечает ни на что
Единственное действие, которое стоит отсюда взять.
Профили пользователей PyPI ему сильно не вредят, аудит безупречен, а показатель доверия высокий, но это больше половины опубликованной поверхности, дающей примерно ноль трафика. На сайте поменьше такое соотношение уже вредит: тонкие страницы размывают обход, а страницы, которые могли бы ранжироваться, конкурируют с миллионом тех, что не могут.
Сходите и пересчитайте собственные типы страниц на этой неделе. Для каждого назовите запрос, который он выигрывает, вслух, другому человеку.
Любой тип, для которого вы не можете назвать запрос, надо закрыть в noindex, убрать из карты сайта или слить с тем, что запрос выигрывает. Инструмент XML Sitemap Generator покажет, что вы отправляете сейчас, против того, что собирались отправлять, и разрыв обычно больше, чем вы ожидаете.
PyPI публикует 2M страниц ради 154K визитов. Интересно не то и не другое, а соотношение, и то, какая одна страница забирает 29% всего. Organic Traffic Checker выдаёт таблицу топовых страниц по любому домену.
- Тот самый отчёт, который нашёл 1 страницу с 29% трафика сайта на 2M страниц
- Расчётные визиты в месяц, доля брендового трафика и тренд за 12 месяцев
- 3 проверки в день, без регистрации и без карты
Что скопировать не получится
И вот что я не смог измерить или должен оговорить. Пара инструментов, которые я называю ниже, наши партнёры: если вы купите по этим ссылкам, мы получим комиссию, а вы не заплатите ни цента сверху.
Наши данные по трафику, это только США, и они смоделированы из позиций и частотности, а не посчитаны. Аудитория PyPI глобальная и в основном не американская, так что мировой трафик у него больше 154K, хотя соотношение числа страниц к трафику, на котором держится статья, переживёт любой разумный множитель. Данные по ключевым словам и ссылкам под этим, от SE Ranking, а $220K, это эквивалент рекламных расходов, а не выручка. PyPI ничего не продаёт.
Ссылочные цифры здесь сняты через приложение, а не через маркетинговый инструмент, который в тот момент упёрся в лимит запросов. Собственная плитка BACKLINKS в отчёте показала 350K, и это неверно (заголовок страницы и разбивка dofollow/nofollow оба дают в сумме 16M, и они сходятся точно, поэтому выше использована именно эта цифра). Плитка, это известный дефект на нашей стороне, и цитировать её я не буду.
Число страниц и разбивка «профили против проектов» взяты из полного обхода собственной карты сайта PyPI 25 августа 2026 года, а не из этого прогона. Keyword Research я не запускал: там открытый дефект, инструмент возвращает неправдоподобные частотности.
И то, что скопировать не получится: быть инфраструктурой. PyPI не нужен поисковый трафик, потому что каждая установка Python на земле обращается к нему напрямую. Судить его по органическим визитам, это ошибка категории: я сделал это здесь, чтобы показать кое-что про число страниц, а не потому, что PyPI в чём-то проваливается.
Частые вопросы
Сколько страниц у PyPI?
2M URL в собственной карте сайта, посчитано полным обходом 25 августа 2026 года: 1.1M профилей пользователей (56%) и 870K страниц проектов (44%). В этом прогоне счёт заново не проверялся.
Сколько поискового трафика получает PyPI?
Примерно 154K расчётных органических визитов в месяц по США с 250K ранжирующихся ключевых слов при средней позиции 43, замер 4 сентября 2026 года. Наш Domain Overview оценивает это в $220K в месяц как эквивалент рекламных расходов.
Какая страница PyPI получает больше всего трафика?
Страница проекта pip, примерно 44K расчётных визитов в месяц, это 29% всего органического трафика сайта, первое место по запросу «pip». Главная страница вторая с 3%, дальше certifi, requests и pandas.
Почему PyPI получает так мало трафика при таком размере?
Потому что страница пакета отвечает на запрос, который почти никто не набирает. Разработчики узнают имя пакета из документации или от коллеги и ставят его командой, а не ищут. Реальный поисковый спрос есть только у имён, ставших общеупотребительными словами: pip, requests, pandas.
Сколько обратных ссылок у PyPI?
16M обратных ссылок с 100K ссылающихся доменов, замер 4 сентября 2026 года, разбивка 13M dofollow против 2.8M nofollow, около 82% dofollow. Domain Trust 96 из 100, при 4,900 ссылках с .edu с 335 доменов.
Какой у PyPI самый частый анкор?
«PyPI» с 3.9M ссылок, это 25% профиля. Следующие четыре, это общие шаблонные фразы в пределах 45K ссылок друг от друга: «Python Package» (880K), «Python PyPI» (870K), «Python SDK» (870K) и «API Client (Python)» (840K), отпечаток сгенерированной документации и бейджей в README.
Какая у PyPI оценка аудита сайта?
91 из 100 в нашем Website Audit, при 0 критических проблем, 1 предупреждении, 3 замечаниях и 118 пройденных проверках на главной странице. Это лучший технический результат и наибольшее число пройденных проверок среди 10 сайтов, замеренных в этих 2 подборках.
PyPI набирает ключевые слова или теряет?
Слегка теряет. За замеренный период он набрал 6,600 ключевых слов и потерял 6,800, при 3,300 подросших против 4,700 просевших, минус по обеим парам. У заброшенных пакетов страницы остаются, а упоминания, которые делали их находимыми, исчезают.
Одна цифра, которую стоит запомнить
13.
Столько страниц PyPI нужно, чтобы получить 1 поисковый визит в месяц: 2M страниц, 154K визитов.
Никто не собирался строить такое соотношение. Так выходит, когда тип страниц генерируют потому, что есть данные, а не потому, что есть запрос. И сайт вокруг образцовый: 91 из 100, 118 пройденных проверок, Domain Trust 96, 16M обратных ссылок. Ничего из этого не помогает, потому что страницы годны под поиски, которых никогда бы и не случилось.
Поэтому, когда в следующий раз кто-то предложит генерировать страницу под каждую запись, не спрашивайте, сколько получится страниц. Спросите, какой запрос выиграет десятая по типичности страница, и идите проверьте частотность по нему до того, как кто-нибудь напишет строчку кода.
Нашли в своём отчёте что-то неожиданное или меряете это иначе? Мне правда интересно, все использованные инструменты бесплатные, так что каждую цифру можно проверить самому. Замер 4 сентября 2026 года, если не указано иное. Цифры Domain Overview, Organic Traffic Checker, Website Audit и Backlink Analyzer, это бесплатные прогоны наших собственных инструментов, все по США, и все смоделированы, а не посчитаны, где инструмент так и говорит. Число страниц взято из собственной карты сайта PyPI, обход 25 августа 2026 года. Цифра выручки не применима.