Отдельные карточки исследований на ClinicalTrials.gov ранжируются по названиям препаратов: "retratrutide" на 27-й позиции, "ivermectin" на 22-й.
Это единственные страницы-сущности во всей серии из 15 сайтов, которые приносят трафик. У PyPI 870K страниц пакетов не приносят ничего. У Chess.com 800K профилей игроков тоже.
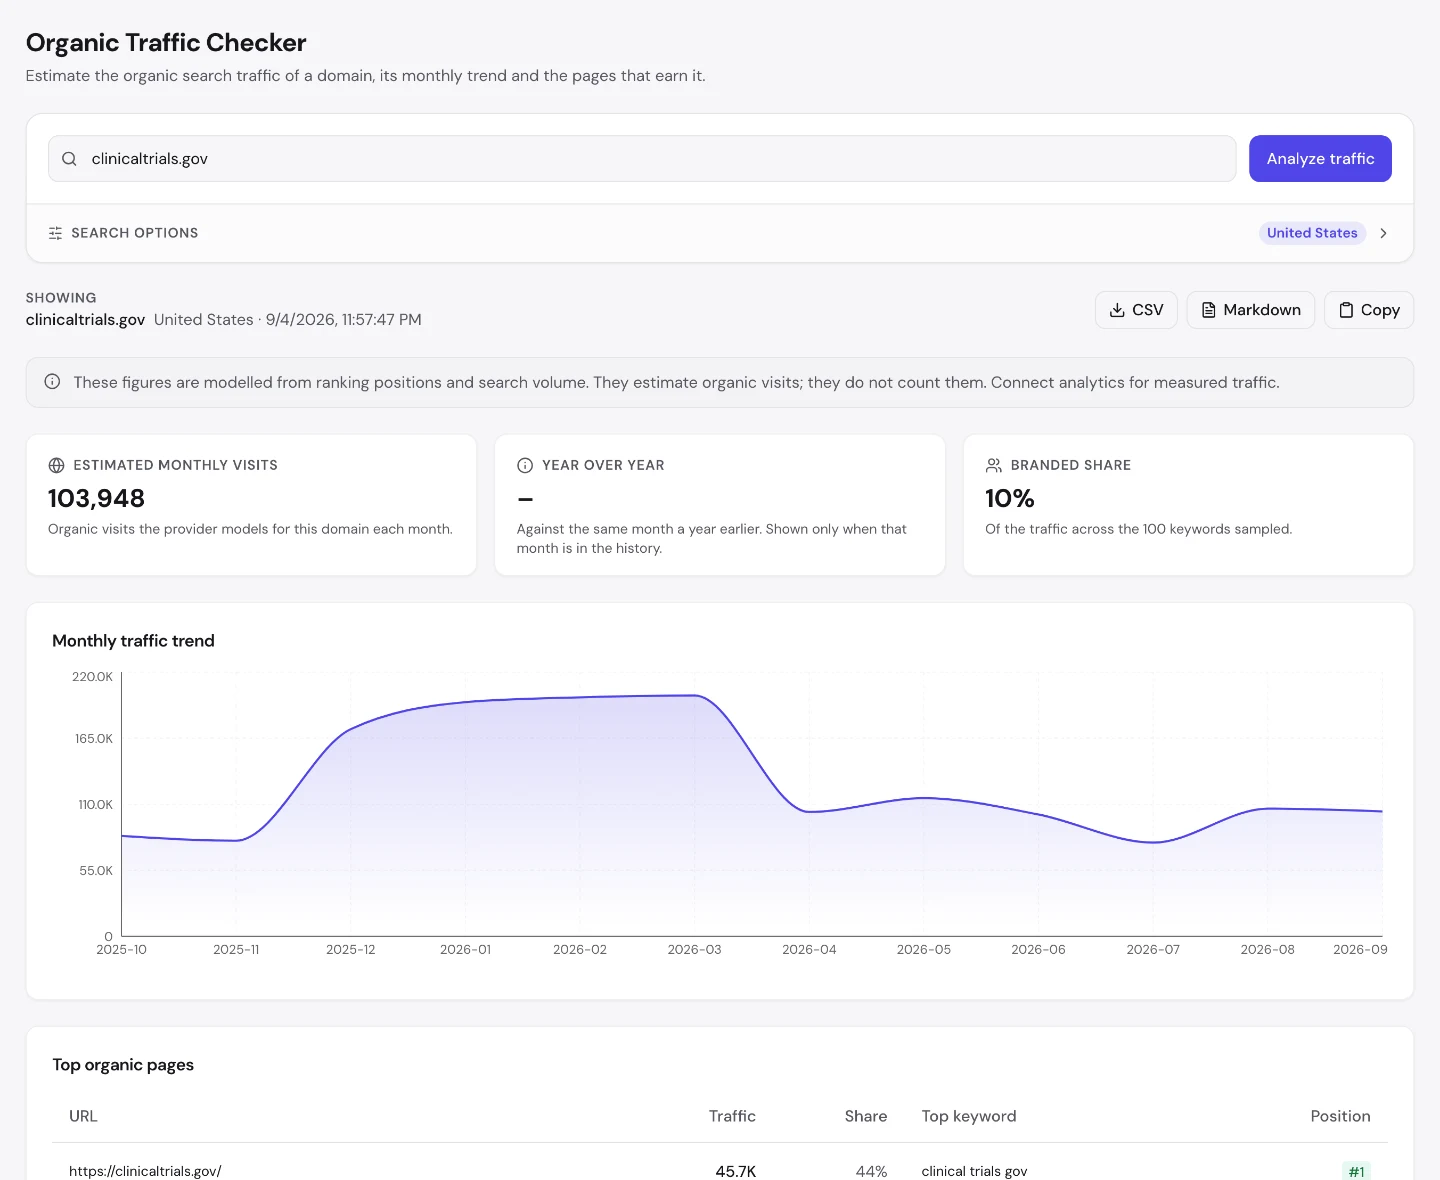
Я прогнал clinicaltrials.gov через 4 наших инструмента. Сайт публикует 600K карточек исследований, получает 100K визитов из поиска и набрал идеальный балл в техническом аудите. Вот 8 уроков, и первый объясняет, почему почти все программно созданные типы страниц проваливаются.
Проверьте сущность до того, как генерировать страницы
Инструмент Проверка органического трафика показывает одну карточку исследования на 27-й позиции по запросу "retratrutide" и другую на 22-й по запросу "ivermectin".
Наша бесплатная проверка даёт текущие цифры. Но прежде чем браться за генерацию страницы под каждую запись, возьмите частотность по реальной выборке из Semrush или SE Ranking: именно на этой цифре держится весь план.
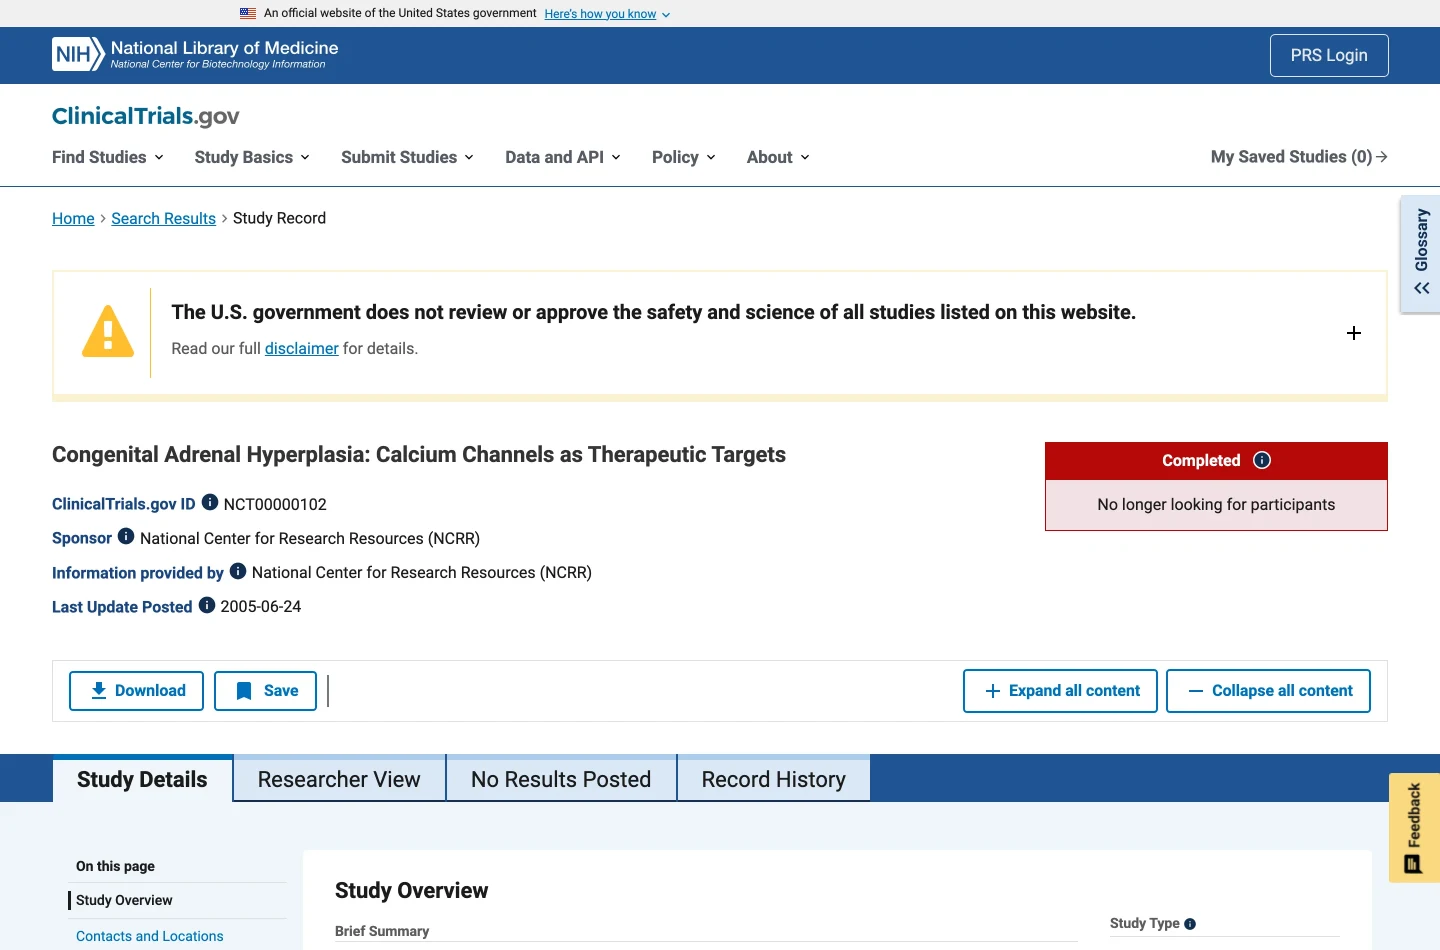
Обратите внимание, по каким запросам ранжируются эти страницы. Не по "NCT07232719": идентификатор исследования никто не набирает. Они ранжируются по названию испытываемого препарата.
В этом весь механизм, и поэтому такой тип страниц работает там, где другие проваливаются. Карточка исследования рассказывает о веществе, которое люди ищут по имени, так что страница наследует реальный спрос от сущности, которую описывает. Страница пакета на PyPI рассказывает о библиотеке, которую никто не ищет, а профиль на chess.com рассказывает о нике, который никто не ищет.
Страницы-сущности ранжируются тогда, когда сущность уже ищут. Это и есть всё правило, и проверить его можно до того, как написана первая строка кода.
Возьмите 20 случайных записей из собственной базы, вбейте их предметы в Подбор ключевых слов и посчитайте, у скольких есть реальный спрос. Не идентификаторы записей, а то, о чём эти записи.
Эта проверка на 20 минут предсказывала результат лучше, чем что-либо ещё в серии. Если большая часть предметов возвращается с нулями, вы собираетесь строить склад, и никакой шаблон его не спасёт.
Планируйте тип страниц по голове спроса
Более ранний обход насчитал 600K карточек исследований против примерно 100K визитов в месяц, то есть около одного визита на 6 записей.
Негусто, но вдвое лучше, чем у PyPI, и по причине выше. Меньшая часть исследований посвящена тому, о чём люди говорят, остальные изучают то, о чём никто не слышал, и не приносят ничего.
Это и есть реалистичное ожидание для любого каталога сущностей, включая ваш. Небольшая голова из записей с искомыми предметами тянет всё на себе, а длинный хвост, это просто склад.
Поэтому планируйте тип страниц по голове, а не по общему числу. Если голова оправдывает разработку, запускайте и пусть хвост существует. Если не оправдывает, хвост его уже не спасёт, а вы потратите квартал на то, чтобы это выяснить.
Оценивайте каталог по той работе, которую он реально делает
Главная страница забирает 44% трафика и стоит на 1-м месте по запросу "clinical trials gov". То есть 600K записей вместе взятые дают меньше, чем входная дверь.
Это уже третий сайт в этой партии с такой формой, после chess.com и Open Library. Очень большой каталог, стоящий за очень небольшим числом страниц, которые реально находят.
Если у вас та же форма, ваш каталог делает не привлечение трафика, а другую работу. Он причина, по которой вам доверяют, когда уже пришли, и причина, по которой главная вообще конвертирует.
Так и измеряйте его, и перестаньте в нём разочаровываться. Если отчитываться каталогом на 600K страниц как SEO-активом, будет казаться, что вы проваливаете задачу, за которую на самом деле не брались.
Пишите меньше объясняющих страниц, чем кажется нужным
Деталь, от которой мне труднее всего оторваться: всего 69 из этих URL не являются карточками исследований.
69 страниц навигации, справки, документации по подаче данных и поиска на реестр из 600K исследований, то есть примерно 8 700 записей на каждую страницу, которая хоть что-то объясняет.
У большинства контент-команд соотношение обратное, а результаты хуже. Если у вас каталог, вам почти наверняка нужно намного меньше объясняющих страниц, чем записано в плане.
А те, что вы всё-таки напишете, должны отвечать на вопрос, с которым приходит незнакомый человек, а не описывать ваш интерфейс. Посмотрите, что вы вообще отправляете в индекс, через Генератор XML-карты сайта: соотношение обычно удивляет.
ClinicalTrials.gov зарабатывает хорошо потому, что работу делают его головные страницы, а не 600K записей. Прежде чем строить страницу под каждый элемент, кто-то должен проверить, что эти элементы вообще ищут. Проверка занимает дни и экономит кварталы.
- Сначала проверка спроса на реальной выборке
- Делаем только те типы страниц, которые могут ранжироваться
- Сайты на базе данных, сделанные как надо
- Фиксированный объём работ, согласованный до старта
Чините критичные ошибки, но ничего не ждите от балла
Аудит сайта выдаёт 100 из 100, и нигде ничего не помечено.
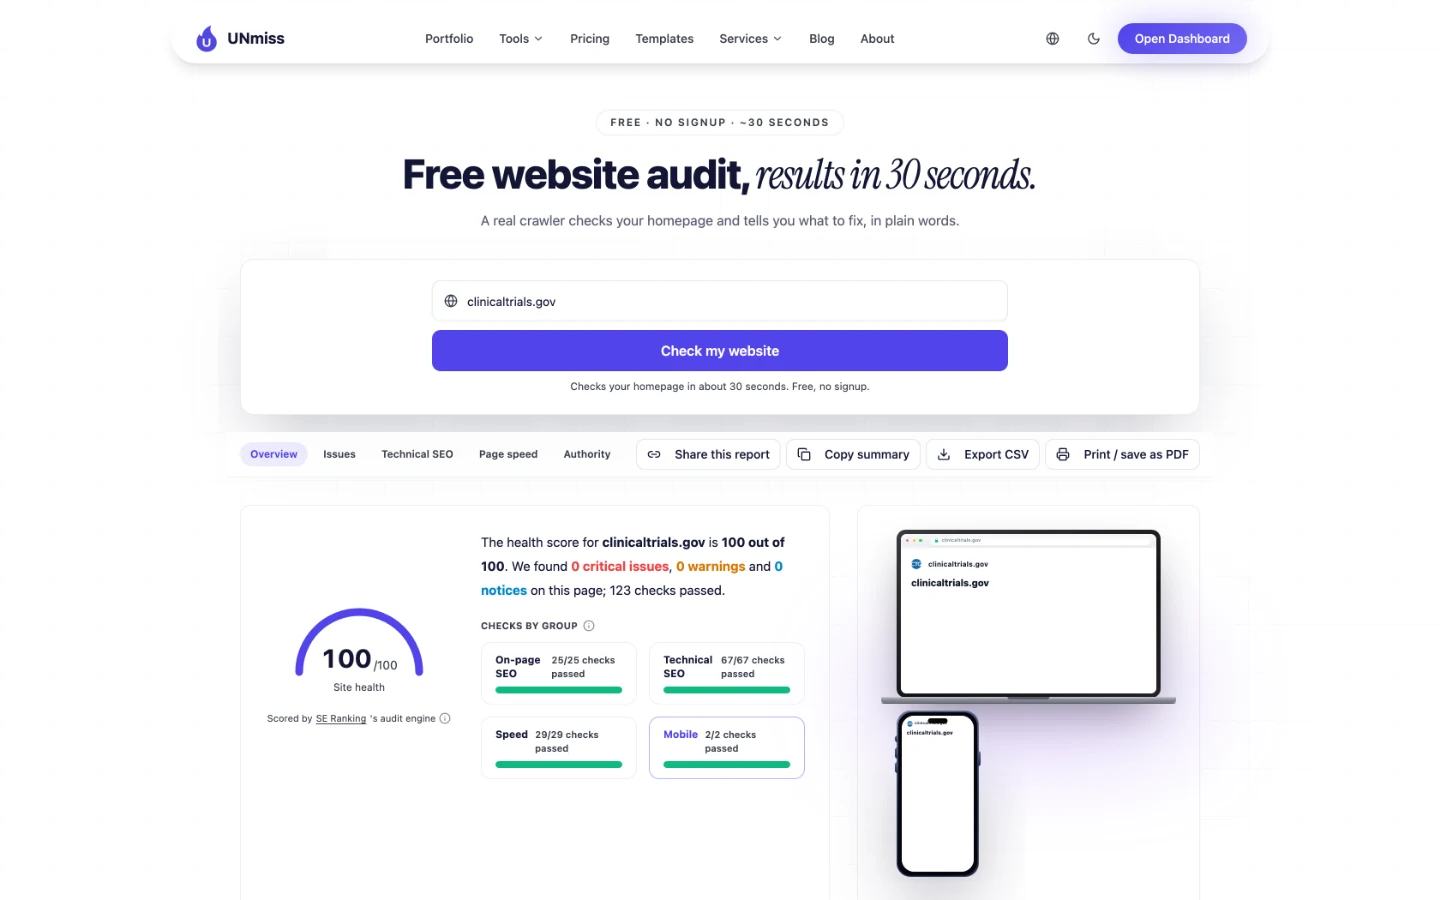
Второй идеальный балл в этой партии, после Dribbble, и именно эти два сайта здесь единственные, кто теряет ключевые слова быстрее, чем набирает.
На 15 сайтах технический балл и результаты в поиске не показали вообще никакой связи. Healthline набирает 74 и растёт быстрее всех. PyPI набирает 91 и имеет худший трафик на страницу из всех здесь. Обе идеальные сотни в упадке.
Так что чините критичные ошибки, они дешёвые и ломают конкретные страницы. А потом перестаньте смотреть на балл.
Если аудит зелёный, а трафик стоит, ещё месяц технических работ ничего не изменит, и вы потратите его на доказательство этого факта.
Вы арендуете внимание к сущности
Из Обзора домена: сайт теряет больше ключевых слов, чем набирает.
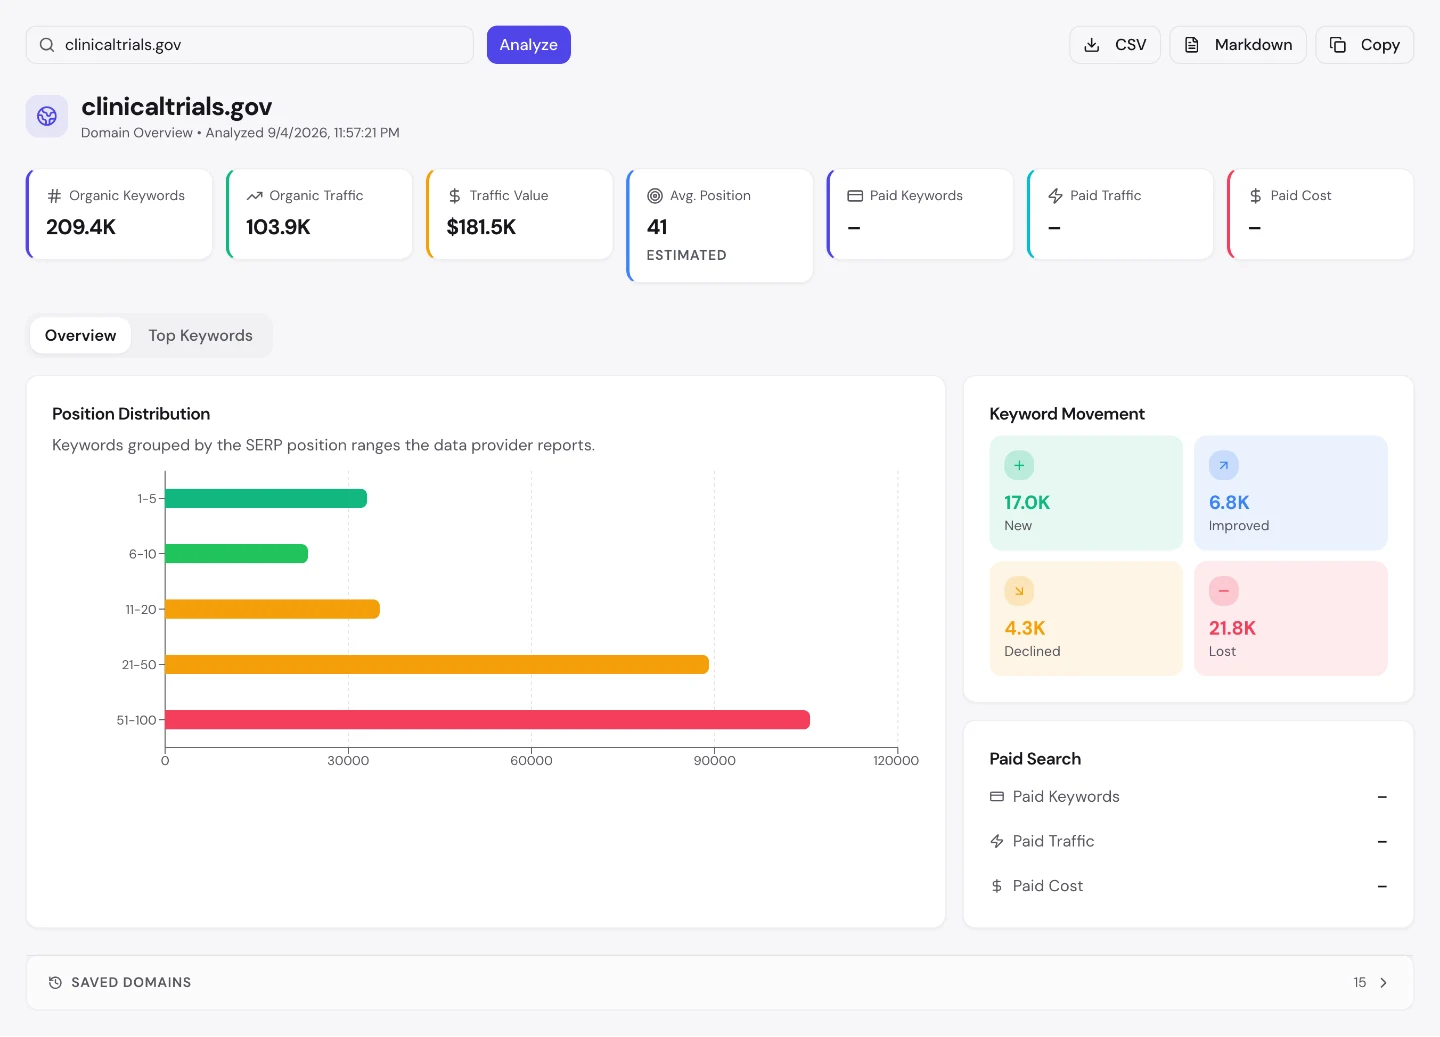
Это тот же механизм названий препаратов, только в обратную сторону, на реестре, который всё время только растёт. Исследование ранжируется, пока его препарат в новостях, и выпадает, когда внимание уходит. Страница не менялась, изменился спрос.
Если ваш трафик зависит от именованных сущностей, вы арендуете внимание чужого новостного цикла, и когда он идёт на спад, это не провал вашего SEO.
Важно это в основном для того, как вы об этом отчитываетесь. Держите такие запросы в Отслеживании позиций, чтобы видеть падение заранее и чтобы показать: дело в спросе, а не в том, что вы что-то сломали.
Поймите, что вас защищает: привычка или позиции
Доля брендового трафика: 10%, при том что главная забирает 44% трафика и стоит на 1-м месте по запросу "clinical trials gov".
Оба факта верны, потому что сам брендовый запрос маленький. Люди ищут препарат, заболевание или фразу "clinical trials", и сайт впитывает этот спрос, хотя никто не ищет учреждение по названию.
От этого различия зависит, насколько вы уязвимы. Chess.com с его 92% брендового трафика защищён привычкой: смена алгоритма не помешает людям набирать его название. ClinicalTrials.gov защищён позициями, а они могут сдвинуться уже в следующем месяце.
Разберитесь, на что опираетесь вы. Если на позиции, то ваш трафик, это рубеж, который приходится постоянно оборонять, а не актив, которым вы владеете.
Публикуйте запись, называйте предмет
Инструкция, вытекающая из всего сказанного выше.
Урок GOV.UK в прошлой партии был такой: публикуйте запись, решения трибуналов, руководства, статистику. ClinicalTrials.gov добавляет вторую половину: следите, чтобы каждая запись называла то, что люди ищут, в заголовке и первой строке.
Карточка исследования, которая начинается с "NCT07232719", невидима. Та, что начинается с испытываемого вещества, находится. Данные те же, поверхность разная.
Примените это к тому, чем являются ваши записи: делам, инцидентам, товарам, спецификациям. Вытащите именованную сущность из записи и поставьте туда, где на неё первыми наткнутся и поисковик, и человек. Составьте такую поверхность один раз через Генератор контент-брифа, растиражируйте шаблоном по всему набору, а потом проверьте результат через Аудит сайта.
Карточки исследований ClinicalTrials.gov ранжируются, потому что они про препараты, которые люди ищут по имени. Страницы пакетов PyPI не ранжируются, потому что названия пакетов никто не ищет. Подбор ключевых слов ответит, что именно из этих двух вы собираетесь строить, примерно за минуту.
- Частотность, сложность и интент по названиям сущностей, которые вы бы генерировали
- Прогоните 20 образцов, прежде чем браться за 600K страниц
- 3 проверки в день, без регистрации и карты
Что скопировать не получится
А вот то, что я не смог измерить или вынужден оговорить. Пара инструментов, которые я называю ниже, наши партнёры: если вы купите по этим ссылкам, мы получим комиссию, а вы не заплатите ни центом больше.
Наши цифры по трафику охватывают только США и смоделированы по позициям и частотности, а не посчитаны напрямую. Для федерального реестра США такой охват представительнее обычного, но это всё равно оценка. Данные по ключевым словам и ссылкам под ней идут из SE Ranking, а $181K стоимости трафика, это эквивалент рекламного бюджета, а не выручка: сайт ничего не продаёт.
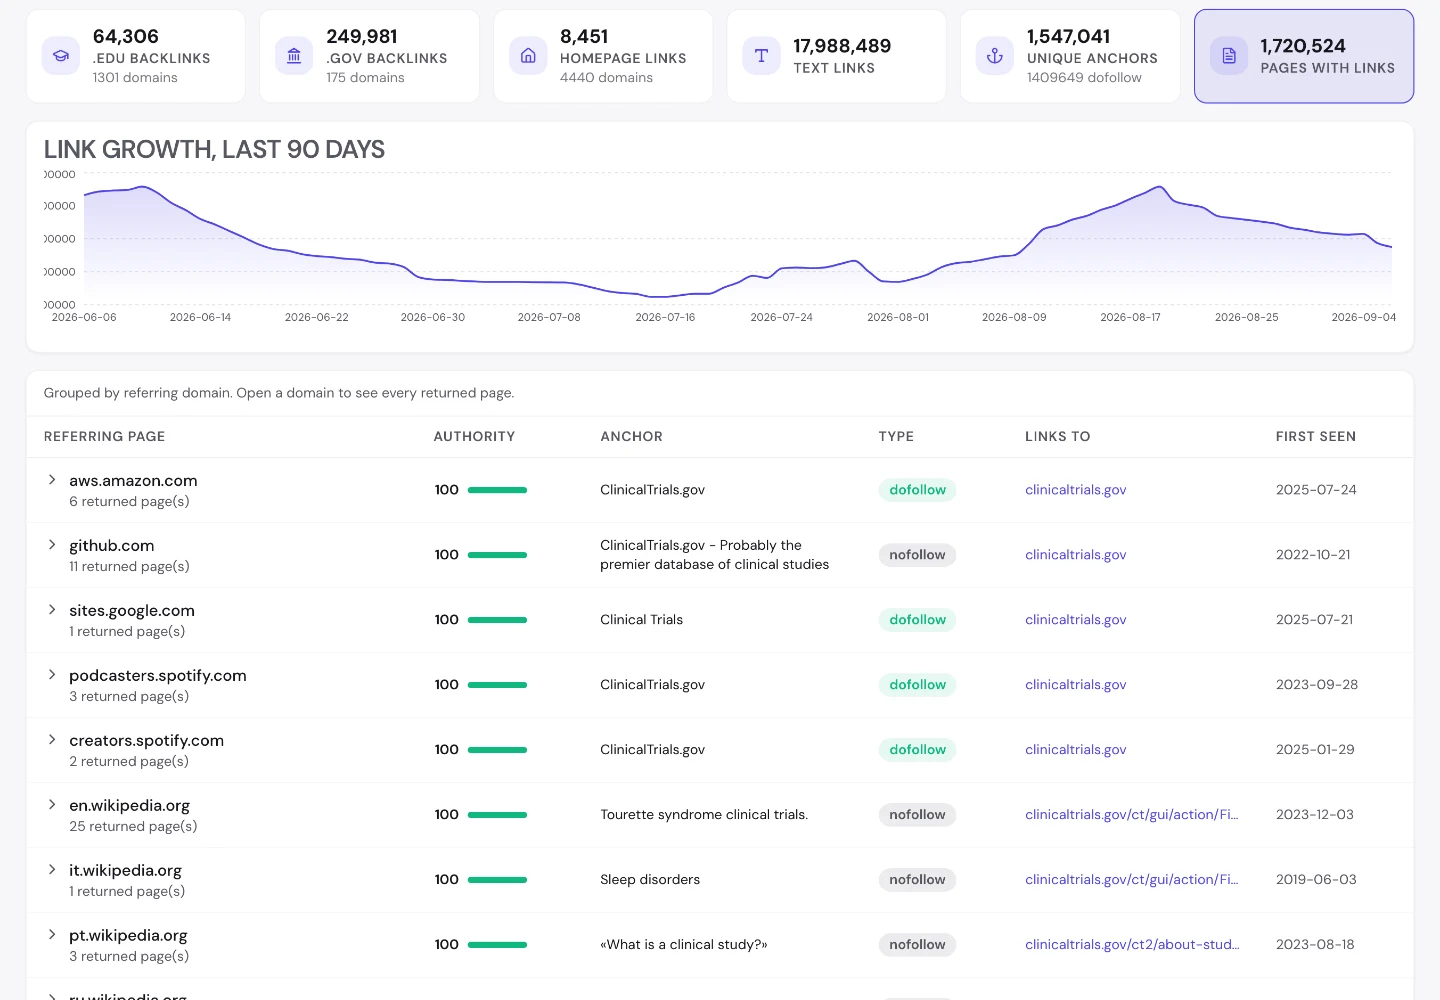
Общая цифра в 18M ссылок взята из приложения, а не из маркетингового инструмента, который на момент съёмки упёрся в лимит запросов (HTTP 429). Плитка BACKLINKS в приложении, это известный дефект на нашей стороне, она возвращала отрицательные значения на других доменах, поэтому цифра выше взята из общего итога в шапке страницы, а скриншот обрезан ниже этой плитки. Более раннее измерение зафиксировало 120K ссылающихся доменов и ранг домена 93.
Перепись карты сайта взята из полного обхода 29 августа 2026 года, а не из этого прогона. Он нашёл 600K карточек исследований, 69 URL не-исследований и идентификаторы от NCT00000102 до NCT07793721. Подбор ключевых слов по набору исследований я не запускал: там открытый дефект, возвращающий неправдоподобную частотность, поэтому вывод про названия препаратов выше прочитан из колонки топовых запросов в самом отчёте по трафику, а не из проверки частотности.
И то, что скопировать не получится: требование закона. Законодательство США обязывает регистрировать здесь многие исследования, так что каталог наполняется сам, а институциональные ссылки идут следом за обязанностью. Ни одному коммерческому сайту наполнение не доставляют по закону.
Частые вопросы
Сколько страниц публикует ClinicalTrials.gov?
600K URL в карте сайта: 600K отдельных карточек исследований и 69 страниц не-исследований, покрывающих навигацию, справку, документацию по подаче данных и поиск, посчитано в полном обходе 29 августа 2026 года. Это примерно 8 700 записей на каждую объясняющую страницу.
Получают ли отдельные карточки исследований трафик из поиска?
Некоторые получают. Две входят в топ-5 страниц сайта: одна примерно с 1 500 визитов в месяц на 27-й позиции по запросу "retratrutide", другая с 1 300 на 22-й по запросу "ivermectin". Они ранжируются по изучаемому препарату и никогда по идентификатору исследования.
Сколько поискового трафика получает ClinicalTrials.gov?
Примерно 100K оценочных органических визитов из США в месяц по 210K ранжирующихся ключевых слов при средней позиции 41, измерено 5 сентября 2026 года. Наш Обзор домена оценивает это в $181K в месяц как эквивалент рекламного бюджета.
Какая страница ClinicalTrials.gov получает больше всего трафика?
Главная, примерно 46K визитов, то есть 44% всего органического трафика, на первом месте по запросу "clinical trials gov". Страница поиска исследований вторая с 4%. Все 600K карточек исследований вместе дают меньше, чем входная дверь.
Какой балл у ClinicalTrials.gov в аудите сайта?
100 из 100: 0 критичных ошибок, 0 предупреждений, 0 замечаний и 123 пройденные проверки на главной. Это один из всего 2 идеальных баллов на 15 измеренных сайтах, наравне с Dribbble, и оба теряют ключевые слова.
ClinicalTrials.gov набирает или теряет ключевые слова?
Теряет. Он набрал 17K ключевых слов и потерял 22K, то есть чистая потеря около 4 800 при базе в 210K, хотя записи только добавляются и никогда не удаляются. Исследования ранжируются, пока их препарат в новостях, и выпадают, когда внимание уходит дальше.
Сколько обратных ссылок у ClinicalTrials.gov?
18M обратных ссылок, измерено 5 сентября 2026 года. Более раннее измерение зафиксировало 120K ссылающихся доменов и ранг домена 93. Медицинские, научные и новостные цитирования накапливаются без всякого аутрича, потому что реестр и есть канонический источник.
Почему страницы-сущности PyPI и chess.com проваливаются там, где эти работают?
Потому что сущность должна быть тем, что люди уже ищут. Карточка исследования, это названный препарат с публичным спросом за ним. Страница пакета PyPI, это библиотека, которую разработчики ставят командой, а профиль на chess.com, это ник, который никто не набирает в Google.
Одна цифра, которую стоит запомнить
27.
Это позиция, на которой одна карточка исследования стоит по запросу "retratrutide", и это самая полезная цифра во всей серии для тех, кто планирует программный тип страниц.
27-я позиция, это третья страница выдачи. При любом обычном прочтении это не победа. И всё равно она выводит страницу в топ-5 сайта, потому что за запросом стоит реальный спрос, а 600K братских страниц на том же самом шаблоне не приносят вообще ничего.
Переменной никогда не был шаблон. Переменной был спрос за каждой записью.
Поэтому, прежде чем что-то генерировать, возьмите 20 своих записей, посмотрите, о чём каждая из них, и проверьте, ищет ли это кто-нибудь. Если для 18 из них ответ отрицательный, вы собираетесь построить склад и назвать его контентом.
Нашли в своём отчёте что-то неожиданное или меряете это иначе? Мне правда было бы интересно узнать: все использованные инструменты бесплатные, так что каждую цифру вы можете проверить сами. Измерено 5 сентября 2026 года, если не указано иное. Цифры из Обзора домена, Проверки органического трафика, Аудита сайта и Анализатора обратных ссылок получены в бесплатных прогонах наших собственных инструментов, все с охватом США и все смоделированы, а не посчитаны, там, где инструмент об этом говорит. Перепись карты сайта взята из собственной карты сайта, обойдённой 29 августа 2026 года. Цифры выручки здесь неприменимы.