Ми запитали файл llms.txt у 67 компаній, і жодне медіа чи рітейлер його не написали.
Люди, які найбільше бояться, що AI з'їсть їхній трафік, не написали того файла, який нібито має допомогти.
llms.txt, це запропонований стандарт: markdown-покажчик у корені вашого сайту, який розповідає мовній моделі, що на сайті є і де лежать хороші сторінки. За 2 роки ніхто так і не поміряв, хто насправді його публікує. Тож це зробили ми, 6 вересня 2026 року, причому перезапустили дослідження з нуля, а не передрукували ранішній підрахунок. Ось 7 уроків.
Перевірте, хто насправді його опублікував
Кілька доменів відмовили нашому запиту навідріз, це невідомі, а не відсутності. Серед тих, хто відповів, 53% повернули справжній файл.
У розрізі того, що компанія продає, картина зовсім не тонка:
| Що вони продають | Публікують файл |
|---|---|
| SaaS | 88% |
| Інструменти для розробників | 81% |
| AI-лабораторії | 60% |
| SEO-інструменти | 25% |
| Медіа | жодного |
| Рітейлери | жодного |
The New York Times, BBC, The Guardian, Wired, CNN, Healthline, wikiHow, The Verge. Amazon, eBay, Etsy, Walmart, Booking.com, Airbnb, Zillow. Одні з найчитаніших комерційних сайтів у вебі, і жодного llms.txt на всіх.
Якби цей файл був захистом від AI, усе було б рівно навпаки.
Тож перш ніж планувати свій, подивіться, хто на вашому ринку взагалі заморочився. Перевірити список конкурентів, це робота на півдня, і якщо відповідь, це "ніхто", ви дізналися щось корисніше, ніж сказав би вам сам файл.
Кладіть його в документацію, а не на маркетинговий сайт
Ось знахідка, яка пояснює все.
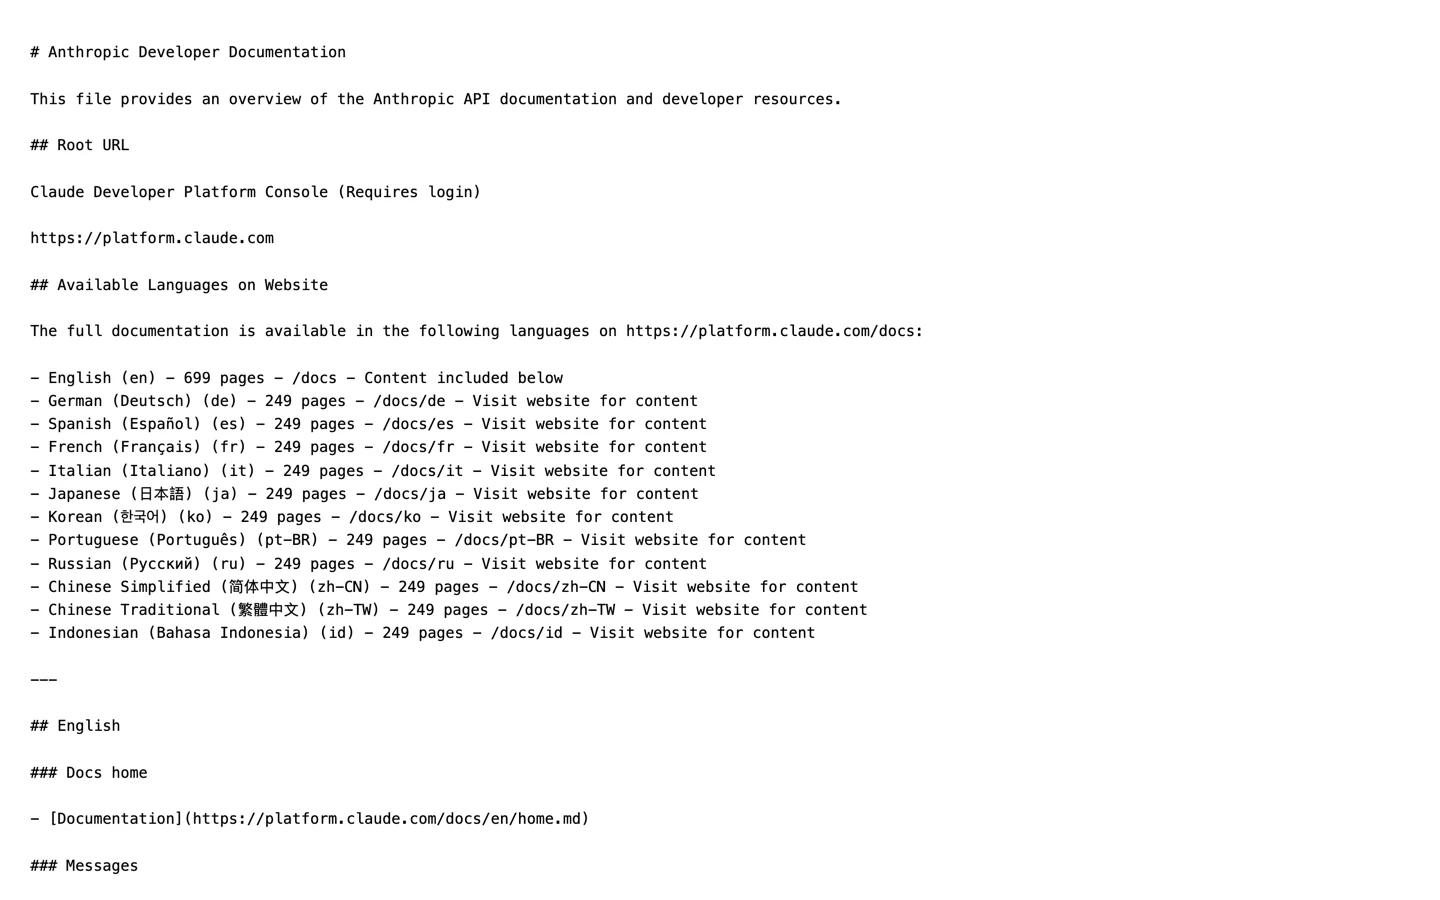
anthropic.com/llms.txt повертає 404. docs.anthropic.com/llms.txt повертає солідний файл.
Той самий розподіл тримається скрізь: Stripe, Perplexity, GitHub, Cloudflare, Mistral і Cohere публікують файл на піддомені документації, а не на маркетинговому. Майже кожен піддомен документації, який ми перевірили, має цей файл; маркетинговий домен перед ним зазвичай ні.
AI-компанія, чий власний продукт споживав би цей файл, не кладе його на свою головну. Вона кладе його в документацію.
Розташування, це найясніша заява про призначення з усіх доступних. Це машиночитний зміст для технічної документації, і публікують його ті компанії, у чиїй документації моделі справді треба вміти орієнтуватися.
Тож кладіть свій туди, де лежать ваші довідкові матеріали. Якщо ви віддаєте документацію з піддомену, саме цей корінь потребує файла: опублікувати його на маркетинговій головній означає проіндексувати ту єдину частину вашого сайту, в якій модель точно б не заблукала.
Не генеруйте його з карти сайту
Медіанний файл, який ми знайшли, це приблизно сторінка посилань. Цілком розумно.
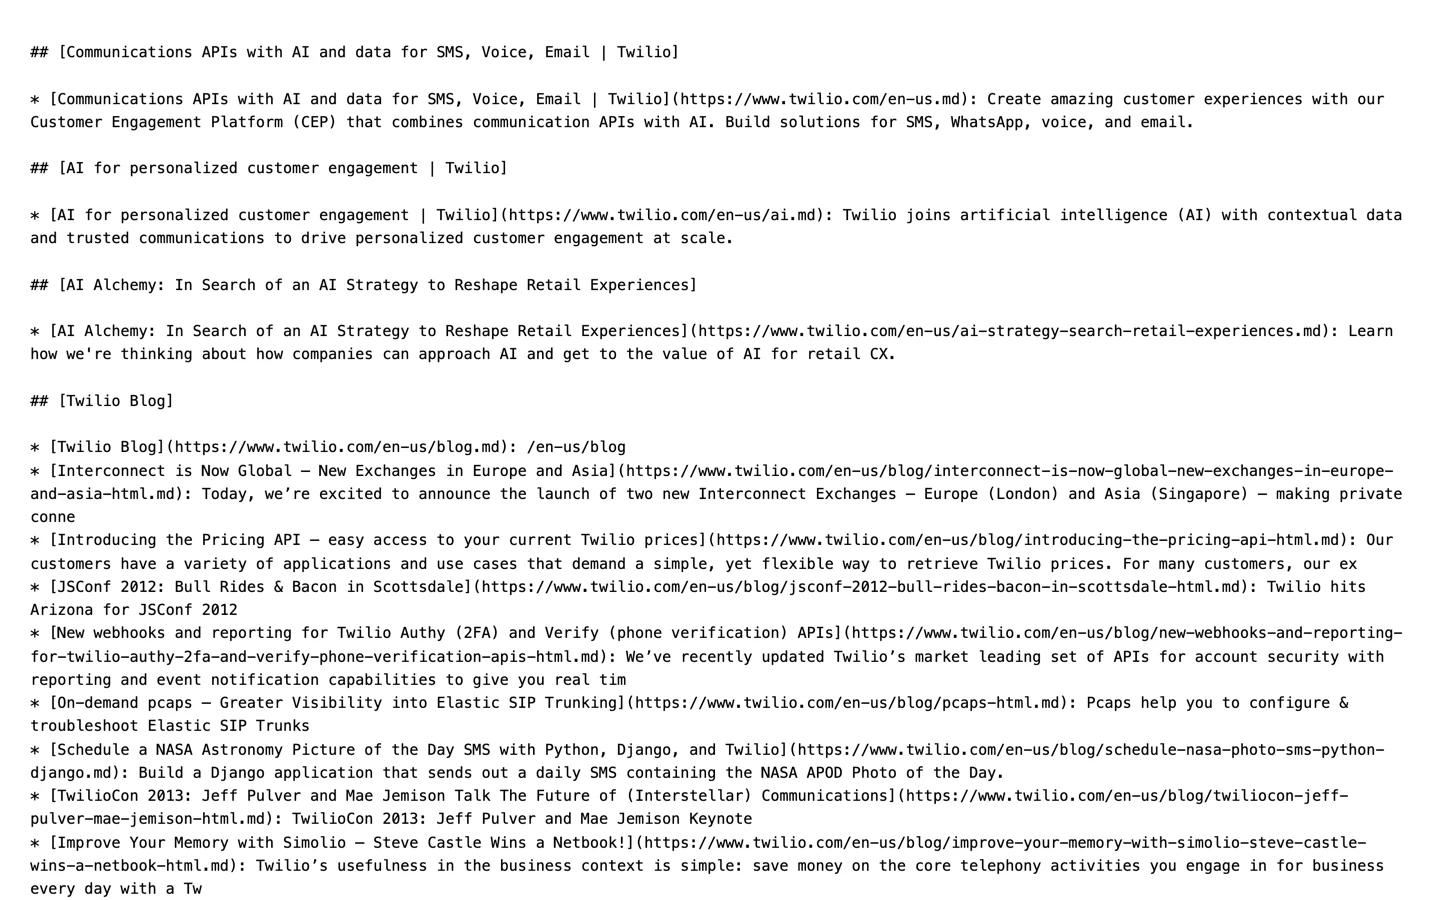
А ще є файл Twilio на 2,3 МБ і понад 9000 посилань, і Zendesk, Mailchimp та Dropbox відстають не набагато.
Зміст із 9000 записів, це вже не зміст. Це сайт, розплющений у файл, уся передумова якого в тому, що він має бути достатньо коротким, аби влізти у контекстне вікно поперед самих сторінок.
У нас 16 посилань. Це не скромність, це формат, який працює як задумано, і Squarespace, Supabase, Netlify та Vercel усі лежать у тому ж діапазоні.
Якщо ви збираєтесь згенерувати свій з карти сайту, саме в цей режим відмови ви й заходите. Індексувати все, це вже робота, яку виконує XML-карта сайту з її жорстким обмеженням розміру саме тому, що машини захлинаються на безмежних списках.
Це безкоштовно і міряє бік AI. Стежте також за пошуковим боком, бо трафік досі там: Semrush і SE Ranking стежать за ним як слід, і жоден з них теж не має чого сказати про llms.txt.
Напишіть свій руками. Якщо ви не можете перелічити власні важливі сторінки без скрипта, це вже само по собі варто знати.
Знижуйте вагу поради, якої сам порадник не послухався
Цей пункт незручний, і ми в ньому теж.
Серед виробників SEO-інструментів, яких ми перевірили, файл публікують лише Semrush і ми самі. Ahrefs, Moz, SE Ranking, Surfer, Sitebulb і Screaming Frog усі повертають 404.
Галузь, яка продає поради про те, як бути видимим для машин, має 25% впровадження файла, який сама ж постійно рекомендує. Читайте це як хочете: як лицемірство або як тихий висновок людей, найближчих до даних, що це поки не має значення. Ми вважаємо, що здебільшого друге.
Застосовуйте той самий тест до всього, що вам скажуть робити наступного разу. Коли людина, яка мала б знати, сама цього не зробила, така мовчанка, це дані, і довіряти їй зазвичай дешевше, ніж статті.
Поки що не показано, що файл llms.txt робить бодай щось. Зате чимало роботи з AI-видимістю показати можна. Якщо ви хочете, щоб вас знаходили і Google, і асистенти, ми чесно скажемо, за які роботи варто платити.
- Міряємо вашу AI-видимість як слід
- Рекомендуємо тільки ту роботу, яку можемо поміряти
- SEO і GEO від однієї команди
- Безкоштовний дзвінок, без зобов'язань
Ніколи не звітуйте цим файлом як результатом
А тепер частина, яку пропускає кожна стаття про цей файл.
llms.txt, це пропозиція. Жодна пошукова система і жоден великий постачальник моделей не публікує документації, де сказано, що він читає цей файл, ранжує з ним або приймає його як вхідні дані. Немає ні тесту на відповідність, ні звітності, ні способу ззовні дізнатися, чи бодай одна відповідь, яку ви колись бачили, була сформована ним.
Ми не можемо поміряти, що він хоч щось робить. Не може й ніхто інший, і саме тому вам ніхто не показав заміру "до і після". Поміряти ви можете інше: чи взагалі AI-асистенти називають ваш бренд і ставлять на нього посилання. Саме це показує наш AI Visibility Checker і саме це число мало б зрушити, щоб цей файл заслужив своє місце.
Публікуйте, якщо хочете. Тільки не вставляйте це у квартальний звіт як роботу, що дала результат, бо ви не зможете її захистити, коли хтось запитає, що саме змінилося.
Зробіть замір до публікації і зробіть його ще раз після. У цьому вся різниця між тим, щоб це зробити, і тим, щоб знати, чи це мало значення.
Пишіть його лише тоді, коли у вас є документація
Це вказівка, і вона прямо випливає з того, де ці файли насправді лежать.
Якщо у вас є документація, довідник API, база знань, довідковий центр на сотні сторінок зі структурою, яку сторонній не вгадає, то llms.txt, це справді корисний артефакт. Ви даєте моделі мапу лабіринту, який побудували самі.
Якщо у вас маркетинговий сайт на 40 сторінок, блог і сторінка з цінами, ви описуєте кімнату, яку модель і так бачить. Ніщо в наших даних не свідчить, що це допомагає, а компанії, яким найлегше про це судити, цього не зробили.
Витратьте ці півдня на те, що можна поміряти. Проженіть свої топові сторінки через Content Optimizer, або знайдіть, за чим ваш сайт не ранжується, через Keyword Research. І те, і те змінює числа, які ви бачите.
Тримайте його в межах 20 КБ
Якщо ви все одно його пишете, ось форма, яку поділяють робочі приклади.
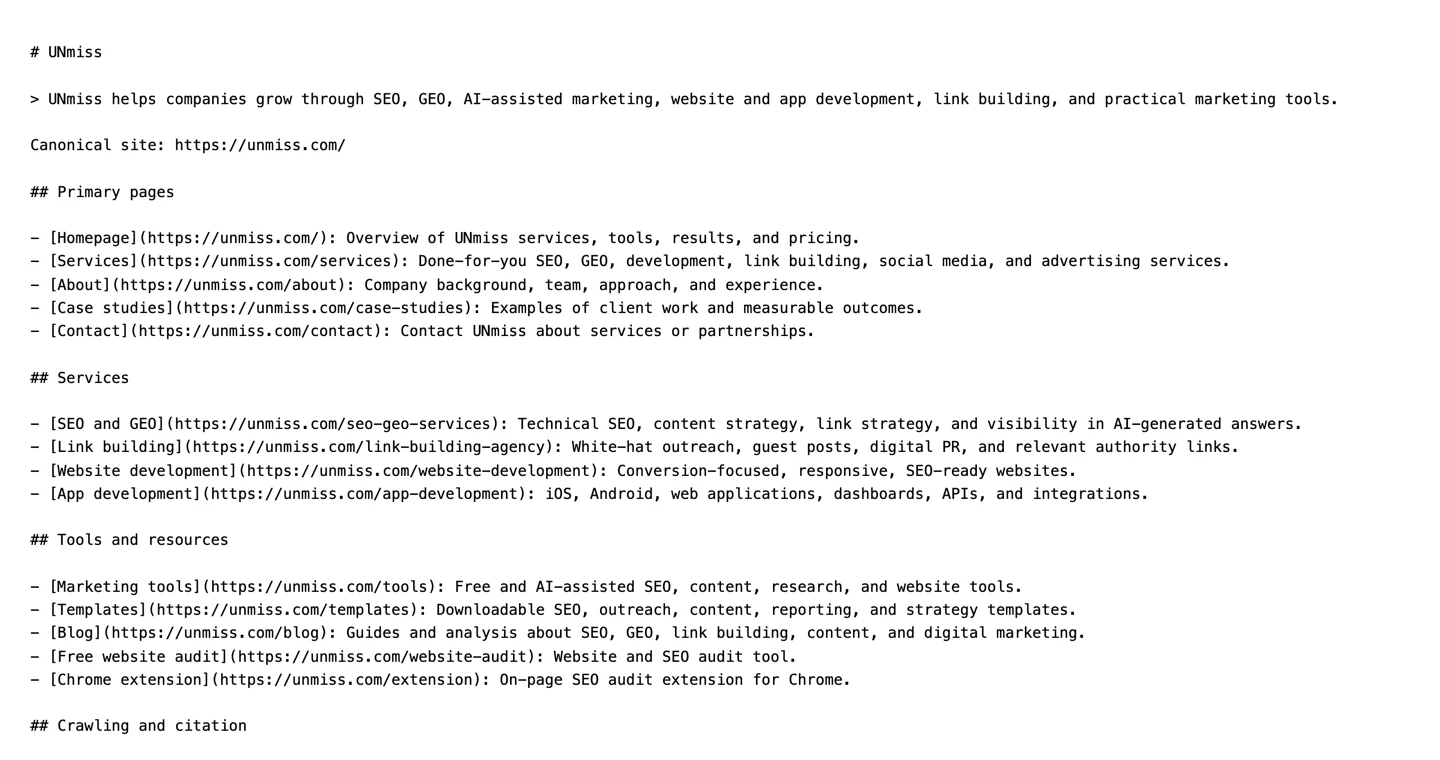
H1 з назвою продукту. Цитата на одне речення про те, що це таке. Далі розділи з посиланнями, Docs, API, Guides, Changelog, по кілька записів у кожному і короткий опис до кожного посилання. Це все, і воно лягає між 2 КБ і 20 КБ.
Кожен файл понад 100 КБ, який ми знайшли, був звалищем. Кожен файл до 20 КБ написала людина. У формату немає жодного примусу, тож єдине, що тримає його корисним, це стриманість того, хто його згенерував.
І перевірте, що файл справді віддається як текст. Кілька сайтів із нашої вибірки відповідають на /llms.txt стилізованою HTML-сторінкою 404 зі статусом 200, і саме так ви починаєте вірити, що опублікували файл, хоча не опублікували.
Ніхто не може показати, що llms.txt змінює відповідь AI. Зате ви можете поміряти самі відповіді: які асистенти називають ваш бренд і чи хтось із них ставить на вас посилання.
- 6 запитань покупця, поставлених без вашої назви бренду
- Згадки і цитування рахуються окремо
- 3 перевірки на день, без реєстрації і без картки
Чого ми не змогли поміряти
А ось те, чого це дослідження не показує. Кілька інструментів, названих на цьому сайті, це наші партнери: якщо ви купуєте за цими посиланнями, ми отримуємо комісію, а ви не платите ні цента більше.
Ми не можемо сказати вам, чи llms.txt працює. Ніщо тут не є контрольованим експериментом. Ми поміряли, хто публікує файл, куди його кладе і якого він розміру, а не те, чи змінилася хоч одна відповідь AI через нього. Якщо хтось показує вам причинно-наслідкове твердження про цей файл, запитайте, якою була контрольна група.
5 із 67 доменів повернули нашому фетчеру 403: npmjs.com, gitlab.com, canva.com, openai.com і perplexity.ai. Це невідомі, тож ми виключили їх із відсотків, а не зарахували як відсутності. Ще один відповів 402. Саме тому в заголовку рахується 62 домени, а не 67.
Статус 200, це ще не файл. Багато сайтів відповідають на /llms.txt стилізованою HTML-сторінкою 404, тож ми нюхаємо перші 400 байтів на предмет розмітки і відкидаємо такі відповіді. Рахувати самі лише коди статусу означало б суттєво роздути це дослідження.
Вибірка, це 67 доменів, які ми обрали у 6 категоріях, а не випадкова вибірка вебу, і вона зміщена в бік компаній, яких впізнає SEO-аудиторія. Інші 67 дали б іншу цифру. Метод описано у файлі scripts/survey-ai-crawler-files.mjs в нашому репозиторії, тож ви можете прогнати його на власному списку.
І одне чесне виправлення: раніша версія цієї статті наводила цифри із запуску 22 серпня 2026 року, сирих даних якого ми не зберегли. Відтворити його ми не змогли, тож для цієї версії все дослідження перезапустили з нуля, і кожне число вище, це 6 вересня 2026 року.
Часті запитання
Що таке llms.txt?
Запропонований стандарт: markdown-файл у корені вашого сайту, який дає мовній моделі покажчик того, що на сайті є і де лежать важливі сторінки. Це пропозиція, а не специфікація, до якої зобов'язалася хоч одна пошукова система чи постачальник моделей.
Скільки сайтів насправді мають llms.txt?
33 із 62 доменів, які нам відповіли, це 53%, поміряно 6 вересня 2026 року на 67 запитах. Лідирує SaaS з 88% та інструменти для розробників з 81%. У медіа 0 з 9, у рітейлерів 0 з 7.
Чи використовують медіа llms.txt?
Жодне з 9, які ми перевірили: the New York Times, BBC, Guardian, Wired, CNN, The Verge, Healthline, Investopedia і wikiHow. Так само жоден із 7 рітейлерів. Компанії, найбільш вразливі до AI-відповідей, цього файла не опублікували.
Чи використовує Google llms.txt?
Жодна пошукова система і жоден постачальник моделей не публікує документації, де сказано, що читає цей файл як вхідні дані для ранжування чи пошуку, і ззовні немає способу перевірити, чи бодай якась відповідь була сформована ним. Ми поміряли впровадження, а не ефект, і контрольованого експерименту про ефект ніхто не опублікував.
Якого розміру має бути llms.txt?
Медіанний файл, який ми знайшли, це 13 тис. байтів, а добре зроблені лежать між 2 КБ і 20 КБ. Найбільший, це файл Twilio на 2,3 млн байтів із 9100 посилань, звалище сайту, а не покажчик, і головний режим відмови цього формату.
Де має лежати цей файл?
На вашому хості документації, якщо він у вас є. anthropic.com повертає 404, тоді як docs.anthropic.com віддає 74 тис. байтів, і 7 з 8 піддоменів документації, які ми перевірили, публікують файл. Цей файл, це мапа технічної документації, а не маркетинговий актив.
Чи публікують SEO-інструменти llms.txt?
2 з 8: Semrush на 15 тис. байтів і seotools.pro на 2200. Ahrefs, Moz, SE Ranking, Surfer, Sitebulb і Screaming Frog усі повертають 404, тобто 25% впровадження в галузі, яка пише більшість статей із рекомендацією його зробити.
Чи варто мені його писати?
Тільки якщо ви публікуєте документацію, в якій сторонній сам не зорієнтується. Для маркетингового сайту на 40 сторінок немає доказів, що це щось дає, а компанії, яким найвигідніше було б, щоб це працювало, здебільшого не заморочувалися.
Одне число, яке варто запам'ятати
0 з 16.
Саме стільки медіа і рітейлерів у цьому дослідженні написали llms.txt: це 16 компаній, чий бізнес найпряміше під загрозою від AI, який відповідає замість того, щоб давати посилання.
Вони не в невіданні щодо проблеми. Як ми з'ясували в супутньому дослідженні того ж тижня, усі 9 із тих самих 9 медіа блокують AI-краулерів у robots.txt. Вони уважно прочитали ситуацію і дійшли висновку, протилежного до того, який постійно рекомендує галузь: не "допоможи моделі краще мене проіндексувати", а "взагалі мене не індексуй".
Ви не мусите з ними погоджуватися. Але перш ніж витрачати півдня на написання файла, бо так сказав допис у блозі, зверніть увагу: люди, які ризикують найбільше і думали про це найдовше, пішли в інший бік.
Поміряно 6 вересня 2026 року. Дослідження запитувало /llms.txt у 67 доменів у 6 категоріях, зараховувало файл як наявний тільки тоді, коли поверталося тіло без HTML зі статусом 200, і виключало 5 доменів, які відповіли 403. Метод, це файл scripts/survey-ai-crawler-files.mjs в нашому репозиторії, а сирі результати лежать у evidence/surveys/, тож ви можете перезапустити його на власному списку і перевірити тут кожну цифру.