Мы запросили файл llms.txt у 67 компаний, и ни один издатель и ни один ритейлер его не написал.
Те, кто больше всех боится, что ИИ съест их трафик, не написали файл, который якобы должен помочь.
llms.txt, это предлагаемый стандарт: markdown-индекс в корне сайта, который рассказывает языковой модели, что у вас есть и где лежат хорошие страницы. Прошло 2 года, а никто так и не замерил, кто его на самом деле публикует. Мы замерили, 6 сентября 2026 года, причём прогнали всё заново, а не перепечатали старый подсчёт. Вот 7 уроков.
Проверьте, кто его вообще опубликовал
Несколько доменов отказали нам сразу, и это неизвестность, а не отсутствие файла. Среди тех, кто ответил, 53% отдали настоящий файл.
В разбивке по тому, что компания продаёт, картина совсем не тонкая:
| Что продают | Публикуют файл |
|---|---|
| SaaS | 88% |
| Инструменты для разработчиков | 81% |
| ИИ-лаборатории | 60% |
| SEO-инструменты | 25% |
| Издатели | ни одного |
| Ритейлеры | ни одного |
The New York Times, BBC, The Guardian, Wired, CNN, Healthline, wikiHow, The Verge. Amazon, eBay, Etsy, Walmart, Booking.com, Airbnb, Zillow. Одни из самых читаемых коммерческих сайтов в вебе, и ни одного llms.txt на всех.
Если бы этот файл был защитной мерой против ИИ, всё было бы ровно наоборот.
Так что прежде чем планировать свой, посмотрите, кто на вашем рынке вообще озаботился. Проверить список конкурентов, это работа на полдня, и если ответ «никто», вы узнали кое-что полезнее того, что сказал бы вам сам файл.
Кладите его в документацию, а не на маркетинговый сайт
Вот находка, которая объясняет всё сразу.
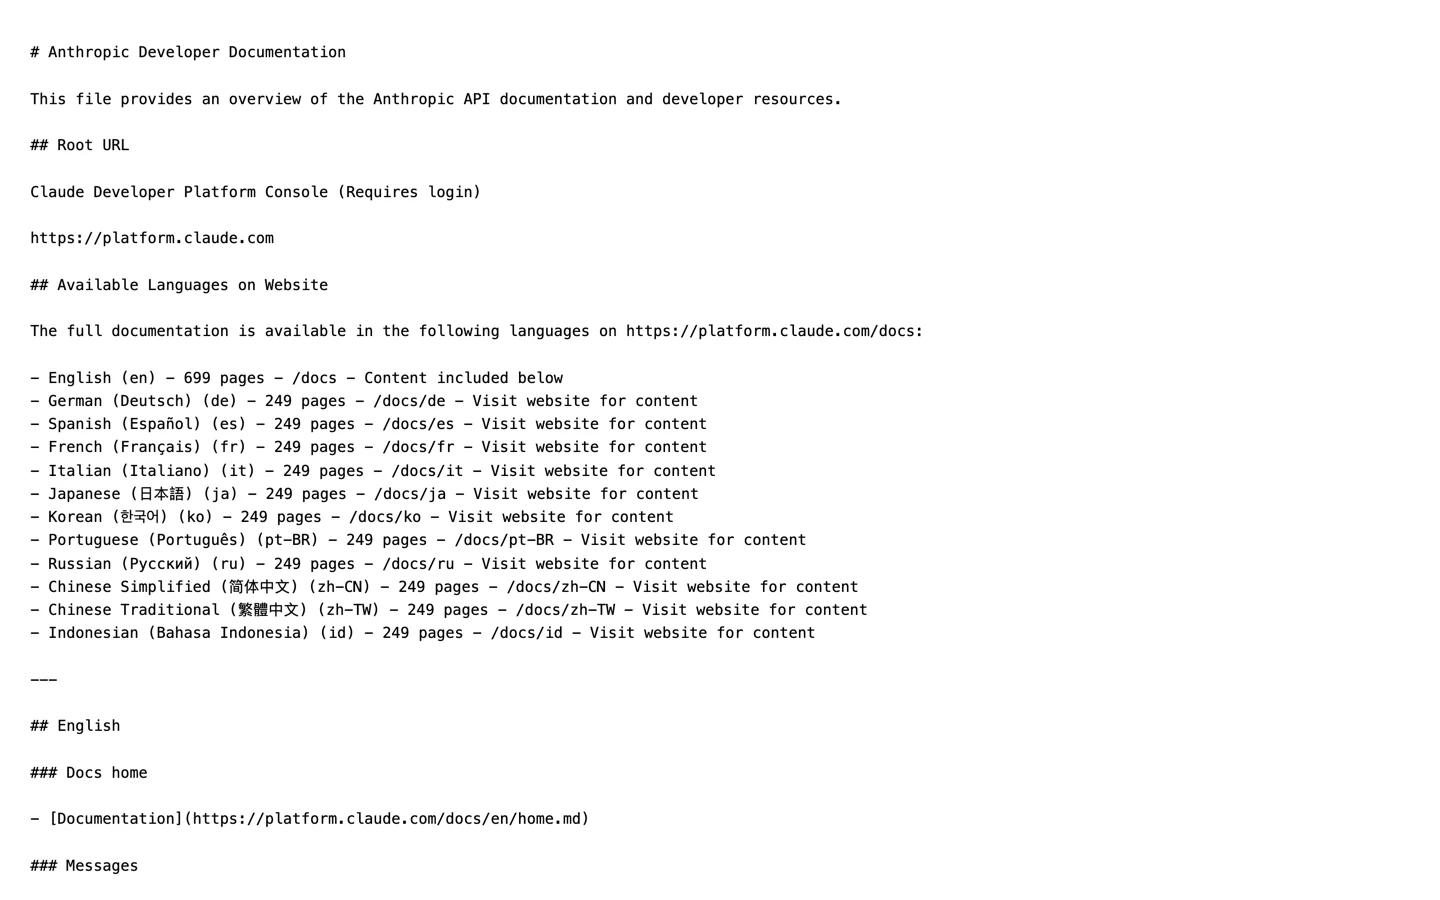
anthropic.com/llms.txt отдаёт 404. А docs.anthropic.com/llms.txt отдаёт увесистый файл.
То же деление держится по всей выборке: Stripe, Perplexity, GitHub, Cloudflare, Mistral и Cohere публикуют файл на поддомене документации, а не на маркетинговом. Почти у каждого проверенного нами поддомена с документацией файл есть; у маркетингового домена перед ним обычно нет.
ИИ-компания, чей собственный продукт и будет этот файл потреблять, не кладёт его на главную. Она кладёт его в документацию.
Размещение, это самое внятное заявление о назначении, какое здесь вообще есть. Это машиночитаемое оглавление технической документации, и публикуют его те компании, по чьей документации модели действительно нужно ориентироваться.
Так что кладите свой туда, где лежат ваши справочные материалы. Если документация у вас на поддомене, файл нужен именно в том корне: публикация на маркетинговой главной индексирует ровно ту часть сайта, в которой модель и так не заблудилась бы.
Не генерируйте его из карты сайта
Медианный файл, который мы нашли, это примерно страница ссылок. Вполне разумно.
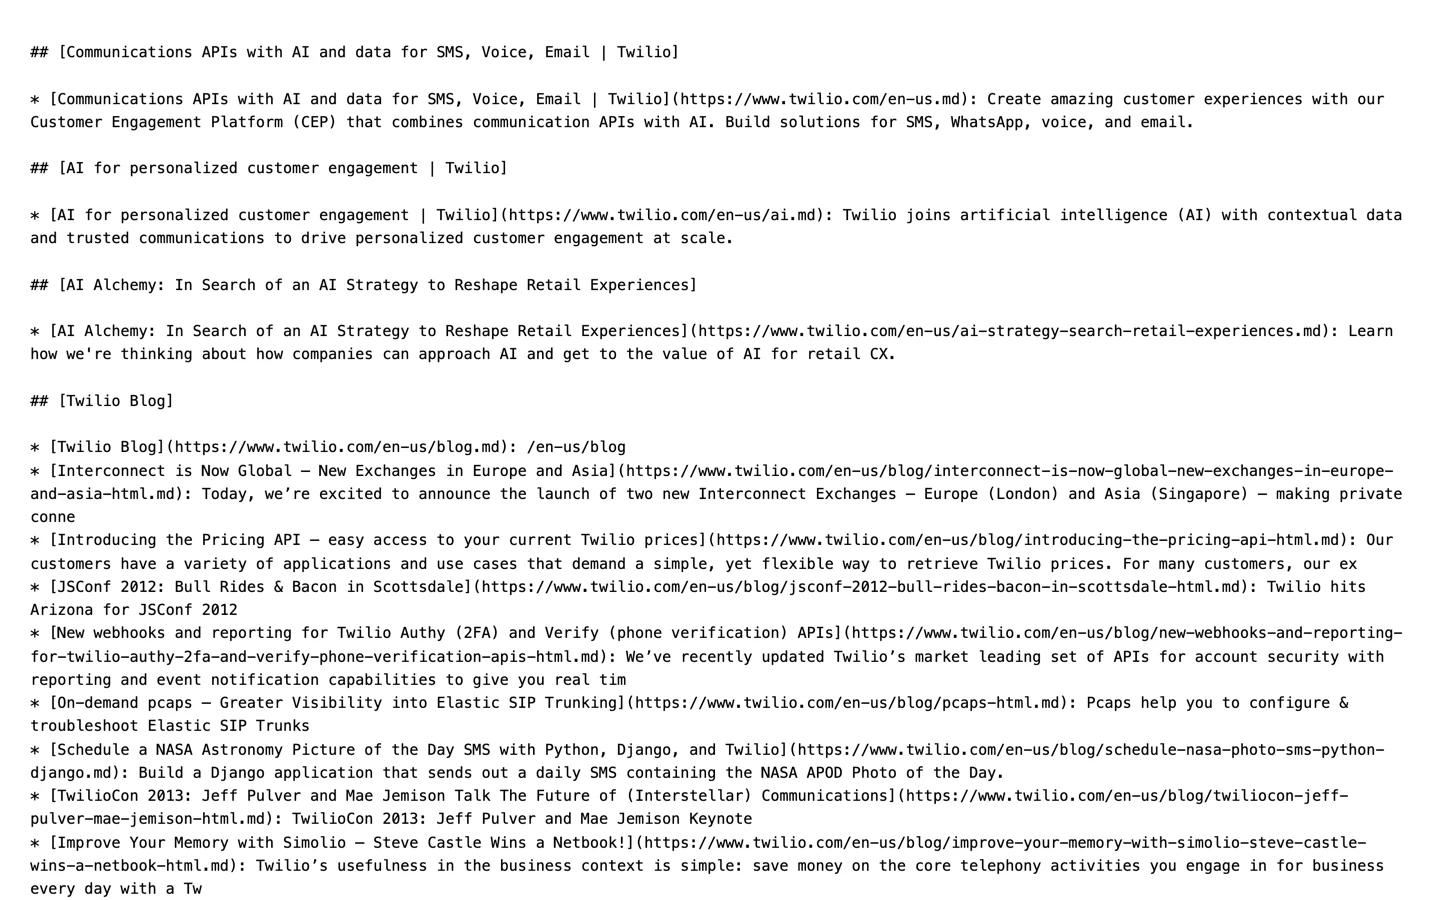
А есть файл Twilio, на 2.3 MB и больше 9,000 ссылок, и Zendesk, Mailchimp и Dropbox отстают от него не сильно.
Оглавление на 9,000 записей, это не оглавление. Это сайт, разложенный в плоскость, в файле, вся идея которого в том, чтобы быть достаточно коротким и влезать в контекстное окно раньше самих страниц.
У нас 16 ссылок. Это не скромность, это формат, работающий как задумано, и Squarespace, Supabase, Netlify и Vercel все в том же диапазоне.
Если вы собираетесь сгенерировать свой из карты сайта, вы идёте ровно в этот сценарий отказа. Индексировать всё подряд, это ровно то, для чего уже существует XML-карта сайта с её жёстким лимитом по размеру, поставленным ровно потому, что машины давятся безразмерными списками.
Это бесплатно и меряет сторону ИИ. Но следите и за поисковой стороной, потому что трафик по-прежнему там: Semrush и SE Ranking отслеживают её как надо, и ни тому ни другому тоже нечего сказать про llms.txt.
Лучше напишите свой руками. Если вы не можете перечислить собственные важные страницы без скрипта, это само по себе стоит знать.
Не верьте совету, которому сам советчик не последовал
Этот пункт неудобный, и мы в нём тоже.
Из проверенных нами вендоров SEO-инструментов файл публикуем только Semrush и мы сами. Ahrefs, Moz, SE Ranking, Surfer, Sitebulb и Screaming Frog отдают 404.
Индустрия, которая продаёт советы о том, как быть видимым для машин, имеет 25% проникновения по файлу, который сама же постоянно рекомендует. Читайте это как хотите: как лицемерие или как тихий вывод людей, сидящих ближе всех к данным, что пока это не важно. Мы думаем, что в основном второе.
Применяйте ту же проверку к любому следующему совету. Когда человек, который должен бы знать, сам этого не сделал, его молчание, это данные, и доверять им обычно дешевле, чем статье.
Про файл llms.txt пока нельзя показать, что он вообще что-то делает. Про многие работы по видимости в ИИ, можно. Если вы хотите, чтобы вас находил и Google, и ассистенты, мы честно скажем, за какие задачи стоит платить.
- Замеряем вашу видимость в ИИ как надо
- Рекомендуем только ту работу, которую можем измерить
- SEO и GEO делает одна команда
- Бесплатный созвон без обязательств
Никогда не отчитывайтесь этим файлом как результатом
Теперь часть, которую пропускает каждая статья про этот файл.
llms.txt, это предложение. Ни один поисковик и ни один крупный поставщик моделей не публикует документацию о том, что читает этот файл, ранжирует по нему или принимает его как вход. Нет ни теста на соответствие, ни отчётности, ни способа со стороны понять, повлиял ли он хоть на один ответ, который вы когда-либо видели.
Мы не можем измерить, что он хоть что-то делает. Не может и никто другой, поэтому вам до сих пор не показали замер до и после. Замерить можно другое: называют ли ИИ-ассистенты ваш бренд вообще и ставит ли кто-то из них на вас ссылку. Именно это и показывает наша Проверка видимости в ИИ в своём отчёте, и это та самая цифра, которая должна была бы сдвинуться, чтобы этот файл оправдал своё место.
Публикуйте, если хочется. Только не вносите его в квартальный отчёт как работу, давшую результат, потому что вы не сможете это защитить, когда вас спросят, что именно изменилось.
Снимите показания до публикации и снимите ещё раз после. В этом вся разница между «сделать» и «понять, было ли от этого хоть что-то».
Пишите его, только если у вас есть документация
Формулирую как инструкцию, и она прямо следует из того, где эти файлы реально лежат.
Если у вас есть документация, справочник по API, база знаний, хелп-центр на сотни страниц со структурой, которую посторонний не угадает, то llms.txt, это действительно полезный артефакт. Вы даёте модели карту лабиринта, который сами же и построили.
Если у вас маркетинговый сайт на 40 страниц, блог и страница с ценами, вы описываете комнату, которую модель и так видит. Ничто в наших данных не говорит, что это помогает, а компании, которым лучше всех знать, этого не сделали.
Потратьте эти полдня на то, что можно измерить. Прогоните свои топовые страницы через Оптимизатор контента, или найдите через Подбор ключевых слов, по чему ваш сайт не ранжируется. И то и другое меняет цифры, которые вы видите.
Держите его меньше 20 KB
Если вы всё же его пишете, вот форма, общая для рабочих примеров.
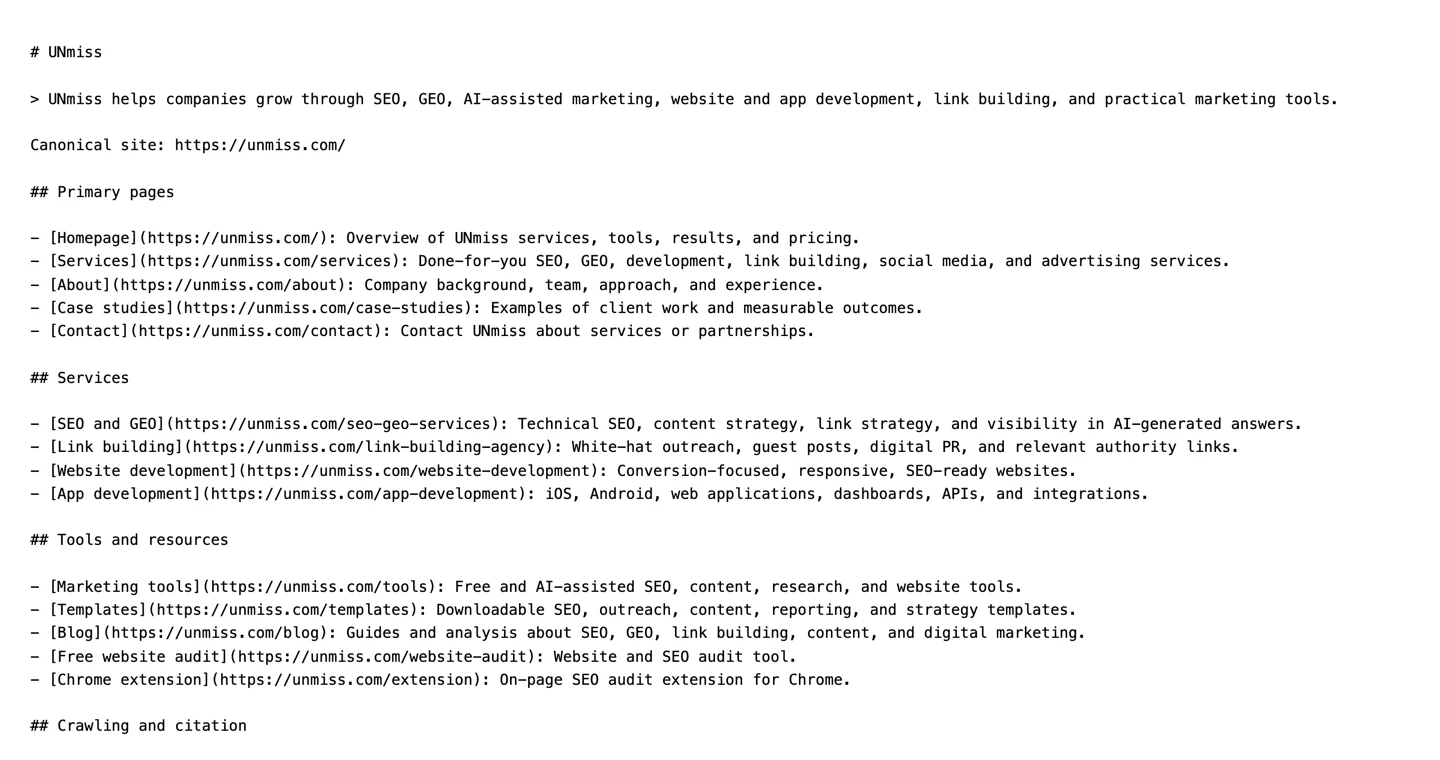
H1 с названием продукта. Цитата в одно предложение, которая говорит, что это такое. Дальше разделы со ссылками: Docs, API, Guides, Changelog, по нескольку записей в каждом и короткое описание к каждой ссылке. Вот и всё, и получается от 2 KB до 20 KB.
Каждый найденный нами файл больше 100 KB был свалкой. Каждый файл меньше 20 KB написал человек. У формата нет никакого принуждения, так что единственное, что держит его полезным, это сдержанность того, кто его собирал.
И проверьте, что файл действительно отдаётся текстом. Несколько сайтов в нашей выборке отвечают на /llms.txt оформленной HTML-страницей 404 со статусом 200, и именно так можно поверить, что вы файл опубликовали, хотя на самом деле нет.
Никто не может показать, что llms.txt меняет ответ ИИ. Зато вы можете замерить сами ответы: какие ассистенты называют ваш бренд и ставит ли кто-то из них на вас ссылку.
- 6 вопросов покупателя, заданных без упоминания вашего бренда
- Упоминания и цитирования считаются отдельно
- 3 проверки в день, без регистрации и без карты
Что мы не смогли измерить
А вот то, чего это исследование не показывает. Пара инструментов, названных на этом сайте, наши партнёры: если вы купите по этим ссылкам, мы получим комиссию, а вы не заплатите ни цента больше.
Мы не можем сказать вам, работает ли llms.txt. Ничто здесь не является контролируемым экспериментом. Мы замерили, кто публикует файл, куда его кладёт и какого он размера, а не то, изменился ли из-за него хоть один ответ ИИ. Если кто-то показывает вам причинно-следственное утверждение про этот файл, спросите, какой была контрольная группа.
403 нашему загрузчику отдали 5 доменов из 67. Это npmjs.com, gitlab.com, canva.com, openai.com и perplexity.ai. Все они неизвестность, поэтому мы исключили их из долей, а не записали в отсутствующие. Ещё один ответил 402. Поэтому в основных цифрах 62 домена, а не 67.
Статус 200, это ещё не файл. Многие сайты отвечают на /llms.txt оформленной HTML-страницей 404, поэтому мы нюхаем первые 400 байт на предмет разметки и такие ответы отбрасываем. Один подсчёт кодов статуса заметно раздул бы это исследование.
Выборка, это 67 доменов, которые мы выбрали по 6 категориям, а не случайная выборка по вебу, и она смещена в сторону компаний, знакомых SEO-аудитории. Другие 67 дали бы другое число. Метод опубликован в scripts/survey-ai-crawler-files.mjs в нашем репозитории, так что вы можете прогнать его по своему списку.
И одна честная поправка: более ранняя версия этой статьи приводила цифры прогона от 22 августа 2026 года, сырые данные которого мы не сохранили. Воспроизвести его мы не смогли, поэтому для этой версии всё исследование прогнали заново, и каждая цифра выше относится к 6 сентября 2026 года.
Частые вопросы
Что такое llms.txt?
Предлагаемый стандарт: markdown-файл в корне сайта, который даёт языковой модели индекс того, что на сайте есть и где лежат важные страницы. Это предложение, а не спецификация, к которой обязался хоть один поисковик или поставщик моделей.
У скольких сайтов на самом деле есть llms.txt?
У 33 из 62 доменов, которые нам ответили, это 53%, замер от 6 сентября 2026 года по 67 запросам. Впереди SaaS с 88% и инструменты для разработчиков с 81%. У издателей 0 из 9, у ритейлеров 0 из 7.
Используют ли llms.txt издатели?
Ни один из 9 проверенных: The New York Times, BBC, The Guardian, Wired, CNN, The Verge, Healthline, Investopedia и wikiHow. И ни один из 7 ритейлеров. Компании, которые сильнее всех подставлены под ответы ИИ, этот файл не опубликовали.
Использует ли Google llms.txt?
Ни один поисковик и ни один поставщик моделей не публикует документацию о том, что читает этот файл как сигнал ранжирования или источник для извлечения, и со стороны никак не проверить, повлиял ли он хоть на один ответ. Мы замеряли распространённость, а не эффект, и контролируемого эксперимента по эффекту никто не публиковал.
Какого размера должен быть llms.txt?
Медианный найденный нами файл, это 13K байт, а нормально сделанные укладываются в диапазон от 2 KB до 20 KB. Самый большой у Twilio, 2.3M байт и 9,100 ссылок, и это свалка сайта, а не индекс, главный сценарий отказа этого формата.
Где должен лежать этот файл?
На хосте вашей документации, если он у вас есть. anthropic.com отдаёт 404, а docs.anthropic.com отдаёт 74K байт, и 7 из 8 проверенных нами поддоменов с документацией файл публикуют. Этот файл, это карта технической документации, а не маркетинговый актив.
Публикуют ли llms.txt SEO-инструменты?
2 из 8: Semrush с 15K байт и seotools.pro с 2,200. Ahrefs, Moz, SE Ranking, Surfer, Sitebulb и Screaming Frog отдают 404, то есть 25% проникновения в индустрии, которая пишет большую часть статей с рекомендацией его завести.
Стоит ли мне его писать?
Только если вы публикуете документацию, по которой посторонний сам не сориентируется. Для маркетингового сайта на 40 страниц нет никаких свидетельств, что от него есть толк, а компании, которым выгоднее всех, чтобы он работал, в основном не озаботились.
Одна цифра, которую стоит запомнить
0 из 16.
Столько издателей и ритейлеров в этом исследовании написали llms.txt, а это 16 компаний, бизнесу которых ответ ИИ вместо ссылки угрожает напрямую.
Дело не в том, что они не знают о проблеме. Как мы выяснили в параллельном исследовании на той же неделе, все те же 9 издателей блокируют ИИ-краулеры в robots.txt. Они внимательно разобрались в ситуации и пришли к выводу, противоположному тому, что постоянно советует индустрия: не «помоги модели проиндексировать меня получше», а «не индексируй меня вообще».
Соглашаться с ними вы не обязаны. Но прежде чем тратить полдня на файл, потому что так сказал пост в блоге, заметьте: люди, у которых на кону больше всех и которые думали об этом дольше всех, пошли в другую сторону.
Замер от 6 сентября 2026 года. Исследование запрашивало /llms.txt у 67 доменов по 6 категориям, засчитывало файл как существующий только тогда, когда со статусом 200 приходило тело не в HTML, и исключало 5 доменов, отдавших 403. Метод лежит в scripts/survey-ai-crawler-files.mjs в нашем репозитории, а сырые результаты в evidence/surveys/, так что вы можете перезапустить его по своему списку и проверить здесь каждую цифру.