Ми розібрали 65 файлів robots.txt на предмет 18 ШІ-краулерів, і кожен видавець у вибірці їх блокує, а жодна софтверна компанія не блокує.
Середини в цих даних немає взагалі. Якщо ваш продукт це читачі, ви блокуєте. Якщо ваш продукт це програмне забезпечення, ви не блокуєте.
Колись robots.txt був звичайною господарською дрібницею: ось папки, які краще не чіпати. Тепер це місце, де компанії публічно заявляють, чи можна на їхній роботі навчати машину і чи можна нею відповідати. Ми повністю переробили це дослідження з нуля 6 вересня 2026 року. Ось 6 уроків.
Подивіться, хто блокує на вашому ринку
Ми запросили robots.txt у 67 доменів, отримали 65 і розібрали кожен по групах user-agent на 18 названих ШІ-краулерів, тобто ботів, які обходять сайти для ШІ-систем.
Приблизно чверть блокує хоча б одного. І розподілені вони зовсім нерівномірно:
| Що вони продають | Блокують |
|---|---|
| Видавці | усі до одного |
| Рітейлери | більше половини |
| SaaS | близько п’ятої частини |
| Інструменти для розробників | ніхто |
| SEO-інструменти | ніхто |
| ШІ-лабораторії | ніхто |
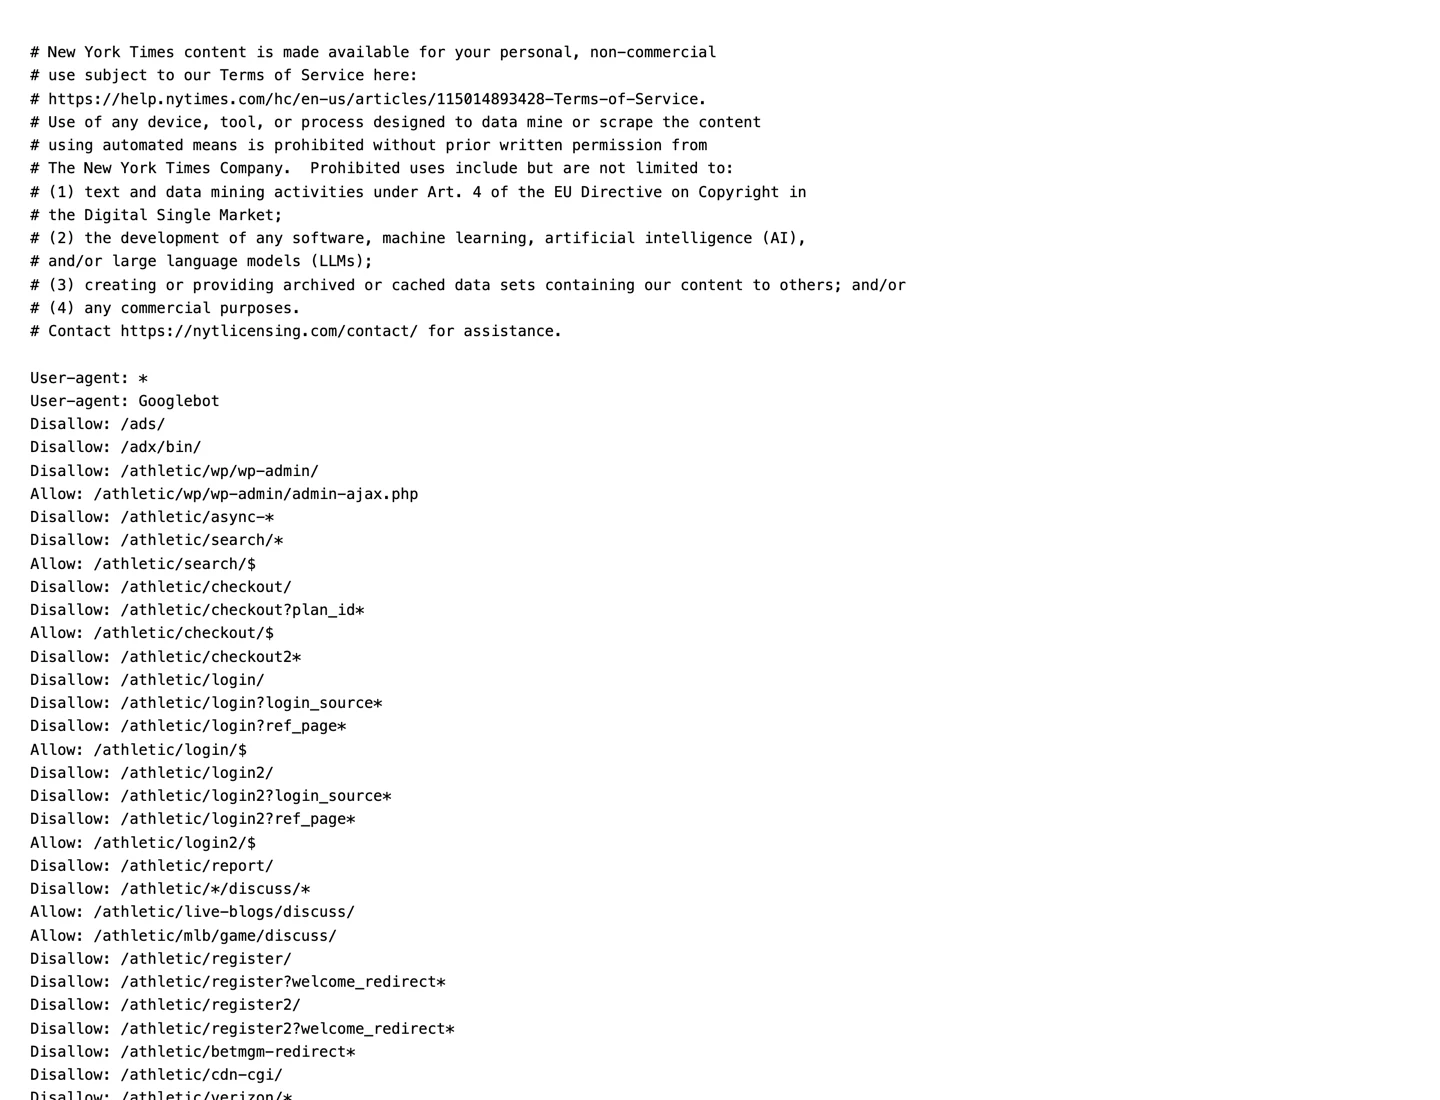
Кожен перевірений нами видавець блокує, і більшість блокує майже весь список. The New York Times і wikiHow зупиняють 17 із 18 протестованих краулерів.
Це ті самі видавці, які, за нашим суміжним дослідженням того ж тижня, не написали файл llms.txt. Вони не вагаються щодо ШІ. Вони вже вирішили, просто в інший бік.
Тож перш ніж чіпати власний файл, зайдіть і прочитайте файли 5 компаній, з якими ви конкуруєте. Це 10 хвилин, і воно скаже вам про висновки вашого ринку більше, ніж будь-яке дослідження, зокрема й це.
Спитайте себе, чи ваша модель це бути знайденим
Тепер інший бік, і він абсолютний.
Інструменти для розробників, SEO-інструменти і ШІ-лабораторії однаково: жодного блокування на весь сайт для жодного ШІ-краулера.
GitHub, GitLab, Stripe, Vercel, Cloudflare, Docker, Supabase, Sentry, Twilio. Ahrefs, Semrush, Moz, SE Ranking, Surfer, Screaming Frog, Sitebulb і ми. Anthropic, OpenAI, Perplexity, Mistral, Cohere, Hugging Face.
Логіка тут проста. Сторінка документації, яку модель прочитала і потім порекомендувала розробнику, робить свою роботу. Новинна стаття, яку модель прочитала і потім відповіла замість вас, ні.
Тож ваша відповідь випливає з вашої бізнес-моделі, а не з якоїсь найкращої практики. Розберіться, до чого з цих двох належать ваші сторінки, перш ніж копіювати чийсь файл.
Якщо ваші сторінки існують, щоб їх знайшли і щось за ними зробили, блокування краулера просто викидає вас із відповіді і нічого не захищає. Якщо ваші сторінки і є продуктом, розрахунок повністю перевертається, і жодна загальна порада не ухвалить це рішення за вас.
Ніколи не блокуйте краулер, який повертає посилання
Серед тих, хто блокує, краулери Anthropic зупиняють трохи частіше, ніж краулери OpenAI, а в самому низу списку стоїть OAI-SearchBot, найрідше блокований краулер у дослідженні.
Саме він живить пошукові результати з посиланнями назад. Це краулер, який найімовірніше приведе вам відвідувача, і саме його зупиняє найменше сайтів.
Ось ця різниця і варта уваги, коли ви правите власний файл. Краулер, що тренує модель, і краулер, що повертає цитування, це різні рішення, хоч вони й приходять від однієї компанії і потрапляють в один і той самий скопійований список.
Важливе уточнення, бо раніше ми тут помилилися. У попередній версії цієї статті йшлося, що кожен видавець, який блокує Anthropic, водночас пускає OpenAI, і це пов’язували з ліцензійними угодами. На 65 доменах цей патерн виявився значно слабшим: рівно так роблять лише 2 сайти. Нахил справжній і стабільний. А от гарна історія ні.
Заблокувати ШІ-краулер це рішення про трафік, який більшість компаній ніколи не міряли. Спершу отримайте цифри. Ми покажемо, що вам сьогодні приносять ШІ-асистенти, а потім допоможемо налаштувати файл свідомо.
- Міряємо ШІ-трафік, який ви вже отримуєте
- Пишемо ті правила robots.txt, які ви насправді хотіли мати
- Постійні SEO і GEO, якщо вам це потрібно
- Перша консультація безкоштовна
Перечитайте файл, який ніхто не перечитував
На вершині списку блокувань не GPTBot. Там CCBot, якого блокує більше сайтів, ніж будь-якого краулера, що належить ШІ-компанії.
CCBot це Common Crawl, неприбуткова організація, яка архівує веб із 2008 року, за багато років до того, як хтось почав хвилюватися за дані для навчання. Нижче за нього йдуть meta-externalagent, Bytespider, Applebot-Extended і PerplexityBot.
Ці файли накопичуються. Хтось додав CCBot багато років тому з причини, якої тепер ніхто не пам’ятає, хтось інший вставив список із допису в блозі, і файл ріс. Дуже мало які з них читаються як рішення, ухвалене один раз, свідомо і щодо нинішнього набору краулерів.
Ваш, найімовірніше, такий самий. Відкрийте його і подивіться дату останньої справжньої зміни: якщо ви не знайдете нікого, хто пам’ятає, як її вносили, ви виконуєте чужу думку з епохи, яка вже закінчилася.
Такий самий дрейф видно в кожному технічному файлі, який ніхто не перечитує. Саме це ми побачили, коли того ж тижня перевіряли карти сайту, і саме це перевіряє наш Website Audit, коли дивиться, чи узгоджені ваші правила robots.txt і ваші індексовані сторінки.
Це безкоштовно і закриває ШІ-бік питання. Але перш ніж щось блокувати, варто знати ще й те, що приносить вам звичайний пошук, а це чітко показують і Semrush, і SE Ranking.
Розбирайте групи, а не шукайте назви пошуком
Ось методологічна пастка, яка дасть вам протилежну відповідь.
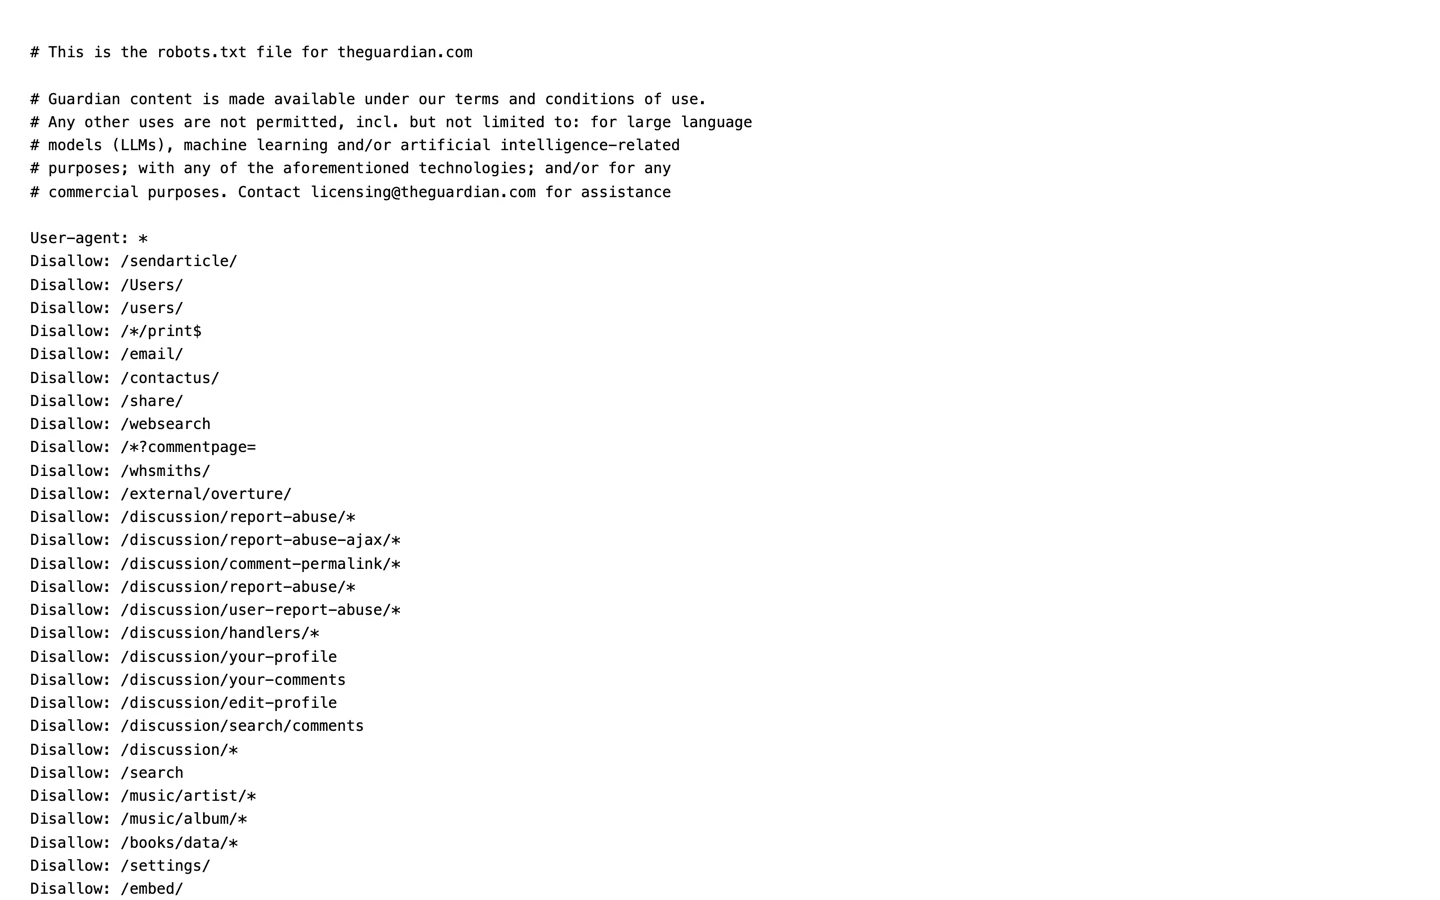
Файл robots.txt організований у групи. Послідовні рядки User-agent: ділять між собою правила, що йдуть за ними, а нова група починається з наступного User-agent: після правила. Краулер заблокований лише тоді, коли група, де він названий, містить Disallow: / на весь сайт.
У наших 65 файлах 91 згадка краулера стоїть усередині груп, які його не блокують: зазвичай це велика дозвільна група, де всі правила лише на рівні шляхів, а десятки ботів названі, щоб дати їм такий самий звичайний доступ, як і всім іншим.
Пошукайте назву бота через grep, і ви порахуєте кожну з цих згадок як блокування. Це не похибка округлення; на деяких сайтах воно повністю перевертає висновок.
Тож якщо ви робите такий аудит у масштабі, розбирайте групи, а не шукайте рядки. Наш скрипт дослідження так і робить, і він лежить у репозиторії, якщо захочете прогнати його на власному списку.
Та сама пастка стосується і вашого файлу. Бот, який ви вважаєте заблокованим, може бути названий у групі, що дає йому все. Ви дізнаєтеся про це, лише прочитавши групу, в якій він сидить, а не рядок, у якому він з’являється.
Прочитайте файл, перш ніж його копіювати
Ось інструкція, і в ній уся практична суть.
Майже кожен список блокувань у robots.txt, що ходить по руках, був скопійований з іншого сайту. Саме тому CCBot обганяє GPTBot, саме тому 91 згадка не є блокуванням, і саме тому стільки файлів називають краулерів, яких уже не існує.
Відкрийте свій. Для кожного ШІ-краулера в ньому дайте відповідь на одне питання: чи вартий уваги відвідувач, який прийде з цієї системи? Для видавця з платною підпискою відповідь часто ні. Для всього, що продається через те, що вас знаходять, відповідь майже завжди так, а OAI-SearchBot, той самий, що повертає посилання, зупиняти хочеться найменше.
А потім, перш ніж щось міняти, перевірте, що ви вже отримуєте від цих систем. Наш AI Visibility Checker ставить 6 питань покупця в основних асистентах і рахує згадки та цитування окремо, а це показує, чи є там узагалі трафік, який треба захищати.
Заблокувати краулер це рішення про трафік, якого ви, можливо, ніколи не міряли. Перевірте, що асистенти кажуть зараз і чи хтось із них узагалі приводить вам людей, перш ніж правити файл.
- 6 питань покупця, поставлених без назви вашого бренду
- Згадки і цитування рахуються окремо
- 3 перевірки на день, без реєстрації і без картки
Чого ми не змогли поміряти
А ось те, чого це дослідження не показує. Кілька інструментів, названих на цьому сайті, наші партнери: якщо ви купите за цими посиланнями, ми отримаємо комісію, а ви не заплатите ні цента більше.
robots.txt це прохання, а не контроль. Він фіксує те, про що сайт просить. Він не каже вам, чи хоч якийсь краулер послухався, і перевірити виконання ззовні ми не можемо. Заблокований краулер у цих даних це заявлений намір.
Ми перевіряли 18 названих краулерів і зараховували блокування лише як Disallow: / на весь сайт усередині групи, де названий цей агент. Правила на рівні шляхів, crawl-delay і агенти з підстановкою не враховані, тож сайт, який блокує ШІ-краулер на більшій частині сайту, але не на всьому, читається тут як такий, що не блокує.
2 з 67 доменів не віддали файл узагалі, це npmjs.com і rust-lang.org, тож знаменник скрізь 65.
Вибірка це 67 доменів, які ми обрали в 6 категоріях зі зсувом у бік компаній, знайомих SEO-аудиторії, і це не випадкова вибірка вебу. Інший список дасть інший відсоток. Метод лежить у scripts/survey-ai-crawler-files.mjs у нашому репозиторії, а сирий результат у evidence/surveys/.
Ми не бачимо приватних ліцензійних угод, і ця версія статті нічого про них не стверджує. Попередня версія стверджувала, спираючись на значно меншу вибірку, і це твердження прибрали, а не переписали.
Часті питання
Скільки сайтів блокують ШІ-краулери?
17 із 65, які ми змогли прочитати, тобто 26%, вимір від 6 вересня 2026 року по 18 названих ШІ-краулерах. Блокують усі 9 видавців, 4 з 7 рітейлерів, 4 з 18 SaaS-компаній і жоден із 31 домену інструментів для розробників, SEO-інструментів і ШІ-лабораторій.
Який ШІ-краулер блокують найчастіше?
CCBot, його блокують 14 із 17 тих, хто взагалі блокує. Він належить Common Crawl, неприбутковій організації, що архівує веб із 2008 року, за багато років до нинішніх тривог про дані для навчання. GPTBot блокують 9 сайтів, а OAI-SearchBot 6.
Чи блокують видавці ШІ-краулери?
Усі 9 у нашій вибірці, у середньому по 14,1 краулера з 18 кожен. The New York Times і wikiHow блокують 17, CNN 17, The Verge і BBC 15, Investopedia 14, Wired 12, Healthline 11, а Guardian 9.
Anthropic блокують частіше за OpenAI?
Трохи частіше. 13 із 17 тих, хто блокує, зупиняють щонайменше один краулер Anthropic проти 10 для OpenAI, а OAI-SearchBot найрідше блокований краулер у дослідженні з показником 6. Лише 2 сайти блокують усі краулери Anthropic і при цьому пускають усі краулери OpenAI.
Чи варто блокувати ШІ-краулери на своєму сайті?
Це випливає з вашої бізнес-моделі. Якщо люди платять за читання ваших сторінок, блокування захищає те, що ви продаєте. Якщо ваші сторінки існують, щоб їх знаходили і щось за ними робили, блокування викидає вас із відповіді, а OAI-SearchBot, краулер, який найімовірніше приведе відвідувача з посиланням, зупиняти хочеться найменше.
Чи справді robots.txt зупиняє краулер?
Це прохання, а не контроль. Файл фіксує те, про що просить сайт; ніщо в ньому нічого не примушує, і перевірити виконання ззовні ми не можемо. Кожна цифра «заблоковано» тут це заявлений намір.
Чому шукати назву бота в robots.txt через grep неправильно?
Бо назвати краулер не означає його заблокувати. У наших 65 файлах 91 згадка краулерів стоїть у дозвільних групах, де всі правила лише на рівні шляхів. Краулер вважається заблокованим тільки тоді, коли група, де він названий, несе Disallow: / на весь сайт.
Чи блокують ШІ-краулери SEO-інструменти?
Жоден із 8 перевірених, разом із нами. Не блокує й жоден із 16 сайтів інструментів для розробників та жодна з 7 ШІ-лабораторій. Софтверні компанії хочуть, щоб їхню документацію читали.
Одне число, яке варто запам’ятати
31 до 0.
Стільки софтверних компаній у цьому дослідженні блокують ШІ-краулер: жодна, проти 9 видавців із 9.
У цих даних не ховається жодної спільної найкращої практики, бо ці 2 групи відповідають на різні питання. Видавець питає, чи може машина замінити собою його продукт. Софтверна компанія питає, чи може машина порекомендувати її продукт.
Ніхто не відповість на це за вас, і жоден список блокувань, скопійований із допису в блозі, теж на це не відповів. Найчастіше блокований краулер у цьому дослідженні належить неприбутковому архіву, старшому за всю цю дискусію, і це добре показує, наскільки те, що лежить у цих файлах, було саме вирішене, а не успадковане.
Відкрийте свій robots.txt. Це 5 хвилин, а він просто зараз робить від вашого імені заяву, якої ви, можливо, ніколи не робили.
Вимір від 6 вересня 2026 року. Ми запросили robots.txt у 67 доменів, розібрали 65 із них по групах user-agent і зараховували краулер як заблокований лише тоді, коли група, де він названий, містила Disallow: / на весь сайт. Протестовані 18 краулерів: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, anthropic-ai, Claude-User, Google-Extended, CCBot, PerplexityBot, Bytespider, Applebot-Extended, meta-externalagent, Amazonbot, cohere-ai, Diffbot, omgili, ImagesiftBot і Timpibot. Метод лежить у scripts/survey-ai-crawler-files.mjs у нашому репозиторії, а сирі результати в evidence/surveys/, тож кожну цифру тут можна перевірити повторним прогоном.