Мы разобрали 65 файлов robots.txt по 18 ИИ-краулерам, и все медиа в выборке их блокируют, а из софтверных компаний не блокирует ни одна.
Никакой середины в данных нет вообще. Если ваш продукт, это читатели, вы блокируете. Если ваш продукт, это софт, вы не блокируете.
Когда-то robots.txt был просто хозяйственным файлом: вот папки, в которые лучше не заглядывать. Теперь это место, где компании публично объявляют, можно ли использовать их работу, чтобы обучать машину и отвечать за них. Мы полностью переснимали это исследование с нуля 6 сентября 2026 года. Вот 6 уроков.
Посмотрите, кто блокирует на вашем рынке
Мы запросили robots.txt у 67 доменов, получили 65 и разобрали каждый по группам user-agent относительно 18 названных ИИ-краулеров.
Примерно четверть блокирует хотя бы одного. И распределены они совсем не ровно:
| Что они продают | Блокируют |
|---|---|
| Медиа | все до одного |
| Ритейл | больше половины |
| SaaS | около пятой части |
| Инструменты для разработчиков | никто |
| SEO-инструменты | никто |
| ИИ-лаборатории | никто |
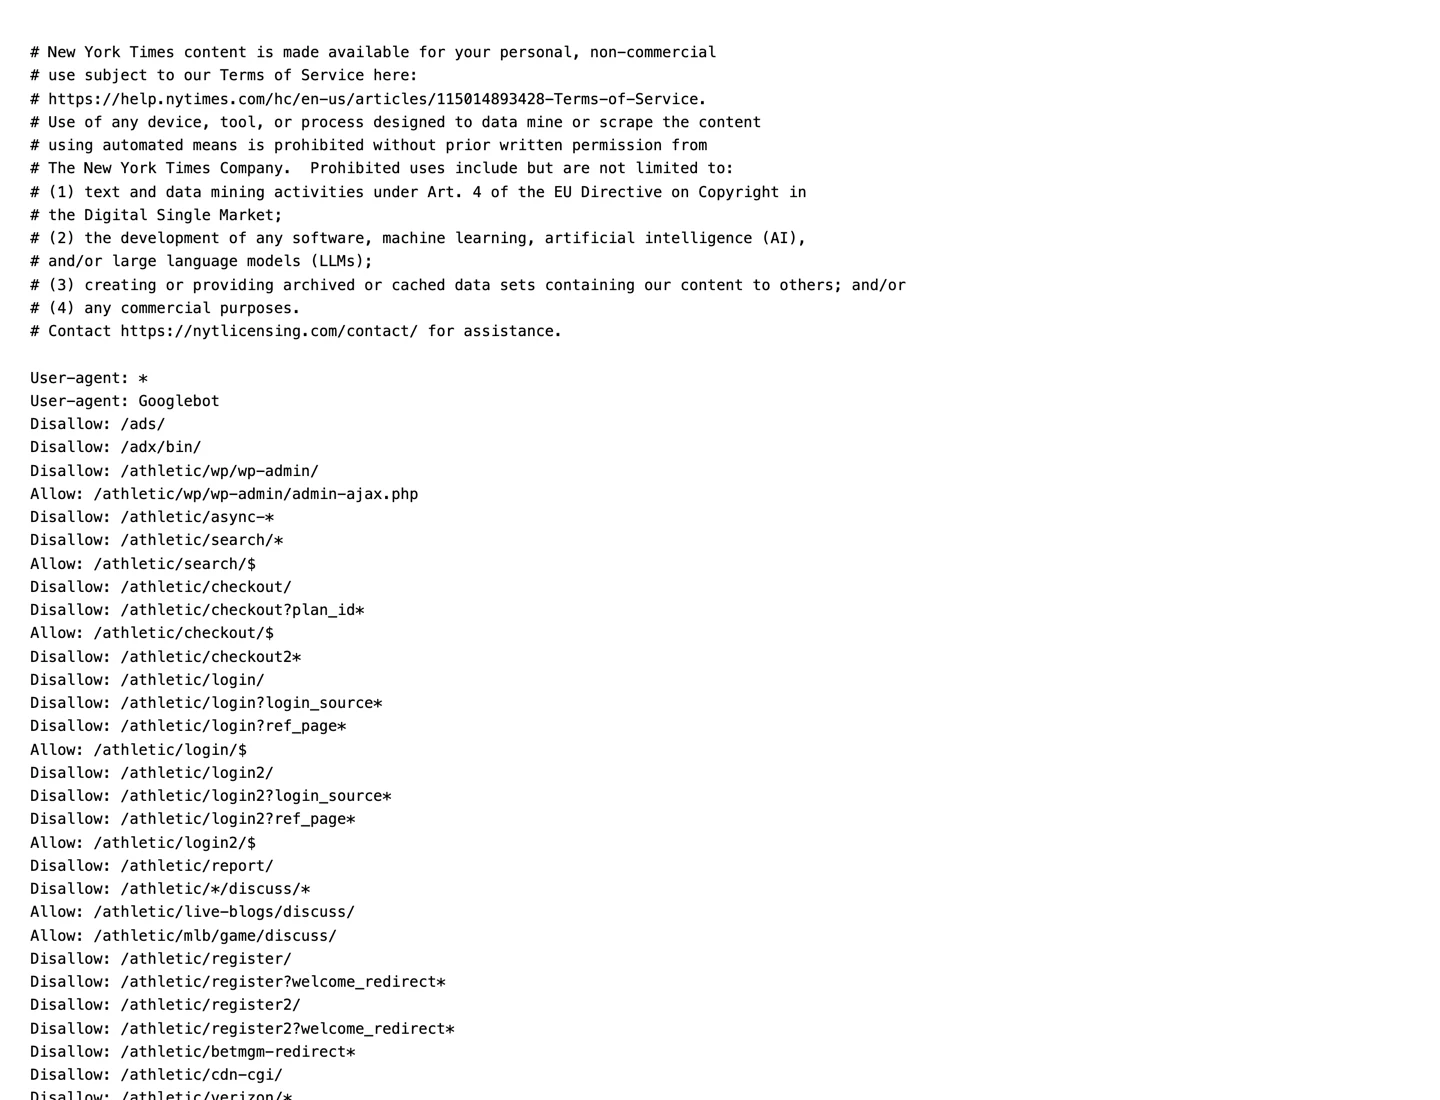
Блокируют все проверенные нами медиа, и большинство блокирует почти весь список. The New York Times и wikiHow останавливают 17 краулеров из 18 протестированных.
Это те же медиа, у которых, по нашему параллельному исследованию той же недели, нет файла llms.txt. Они не колеблются насчёт ИИ. Они уже решили, и решили в обратную сторону.
Так что прежде чем трогать свой файл, сходите и прочитайте файлы 5 компаний, с которыми вы конкурируете. Это 10 минут, и о выводах вашего рынка это расскажет больше, чем любое исследование, включая это.
Спросите себя, строится ли ваша модель на том, чтобы вас находили
Теперь другая сторона, и она абсолютна.
Инструменты для разработчиков, SEO-инструменты и ИИ-лаборатории: ни одной блокировки на весь сайт ни по одному ИИ-краулеру.
GitHub, GitLab, Stripe, Vercel, Cloudflare, Docker, Supabase, Sentry, Twilio. Ahrefs, Semrush, Moz, SE Ranking, Surfer, Screaming Frog, Sitebulb и мы. Anthropic, OpenAI, Perplexity, Mistral, Cohere, Hugging Face.
Логика здесь несложная. Страница документации, которую модель прочитала и порекомендовала разработчику, делает свою работу. Новостная статья, которую модель прочитала и ответила вместо вас, свою работу не делает.
То есть ответ вытекает из вашей бизнес-модели, а не из best practice. Разберитесь, чем из этих двух являются ваши страницы, прежде чем копировать чей-то файл.
Если ваши страницы существуют, чтобы их нашли и по ним что-то сделали, блокировка краулера убирает вас из ответа и ничего не защищает. Если ваши страницы сами и есть продукт, расчёт полностью переворачивается, и никакой общий совет не примет это решение за вас.
Никогда не блокируйте краулер, который возвращает ссылки
Среди блокирующих краулеры Anthropic останавливают чуть чаще, чем краулеры OpenAI, а в самом низу списка сидит OAI-SearchBot, самый редко блокируемый краулер в исследовании.
Именно он питает поисковые результаты со ссылками обратно на вас. Это краулер, который с наибольшей вероятностью пришлёт вам посетителя, и именно его останавливает меньше всего сайтов.
Вот это различие и стоит держать в голове, когда правите свой файл. Краулер, который обучает модель, и краулер, который возвращает цитату со ссылкой, это разные решения, даже если оба приходят от одной компании и попадают в один и тот же скопированный список.
Важное исправление, потому что раньше мы здесь ошиблись. В ранней версии этой статьи мы писали, что каждое медиа, блокирующее Anthropic, одновременно пропускает OpenAI, и связывали это с лицензионными сделками. При перезапуске на 65 доменах эта картина оказалась гораздо слабее: ровно так делают только 2 сайта. Перекос реальный и устойчивый. А вот красивая история нет.
Блокировка ИИ-краулера, это решение о трафике, который большинство компаний никогда не измеряли. Сначала получите цифры. Мы покажем, что вам сегодня присылают ассистенты, а потом поможем настроить файл осознанно.
- Измеряем ИИ-трафик, который вы уже получаете
- Пишем те правила robots, которые вы и хотели иметь
- Постоянное SEO и GEO, если нужно
- Первая консультация бесплатная
Перечитайте файл, который никто не перечитывает
Во главе списка блокировок стоит не GPTBot. Это CCBot, его блокирует больше сайтов, чем любой краулер, принадлежащий ИИ-компании.
CCBot, это Common Crawl, некоммерческая организация, которая архивирует веб с 2008 года, задолго до того, как кто-то начал переживать за обучающие данные. Ниже идут meta-externalagent, Bytespider, Applebot-Extended и PerplexityBot.
Такие файлы накапливаются. Кто-то добавил CCBot много лет назад по причине, которую сейчас никто не помнит, кто-то другой вставил список из статьи в блоге, и файл разросся. Очень немногие читаются как решение, принятое один раз, осознанно и про нынешний набор краулеров.
Ваш, скорее всего, такой же. Откройте его и посмотрите дату последнего настоящего изменения: если вы не найдёте человека, который помнит, как его вносил, вы исполняете чужое мнение из эпохи, которая уже закончилась.
Тот же дрейф вылезает в любом техническом файле, который никто не перечитывает. Ровно это мы нашли, проверяя карты сайта на той же неделе, и ровно это проверяет наш Website Audit, когда смотрит, согласуются ли ваши правила robots с вашими индексируемыми страницами.
Это бесплатно и закрывает сторону ИИ. Ещё до любых блокировок стоит понять, что вам присылает обычный поиск, и это хорошо показывают и Semrush, и SE Ranking.
Разбирайте группы, а не грепайте имена
Вот методологическая ловушка, и она даёт прямо противоположный ответ.
robots.txt устроен в виде групп. Идущие подряд строки User-agent: делят между собой правила, которые идут после них, а новая группа начинается на следующей строке User-agent: после правила. Краулер заблокирован только тогда, когда в группе, где он назван, есть Disallow: / на весь сайт.
По нашим 65 файлам 91 упоминание краулеров сидит в группах, которые их не блокируют: обычно это большая разрешающая группа, где все правила только на уровне путей, а десятки ботов перечислены, чтобы дать им тот же обычный доступ, что и всем остальным.
Сделайте grep по имени бота, и вы засчитаете каждое такое упоминание как блокировку. Это не погрешность округления; на некоторых сайтах вывод переворачивается целиком.
Поэтому если вы проверяете это в масштабе, разбирайте группы, а не ищите строки. Наш скрипт для исследования так и делает, он лежит в репозитории, если хотите прогнать его по своему списку.
Та же ловушка касается и вашего собственного файла. Бот, который вы считаете заблокированным, может быть назван в группе, которая даёт ему всё, и узнаете вы об этом, только прочитав группу, в которой он сидит, а не строку, где он встретился.
Прочитайте файл, прежде чем его копировать
Инструкция, и это главный практический вывод.
Почти каждый ходящий по рукам список блокировок в robots.txt скопирован с другого сайта. Поэтому CCBot стоит выше GPTBot, поэтому 91 упоминание не является блокировкой и поэтому во множестве файлов названы краулеры, которых больше не существует.
Откройте свой. По каждому ИИ-краулеру в нём ответьте на один вопрос: был бы вам полезен посетитель, пришедший из этой системы? Для медиа по подписке ответ часто отрицательный. Для всего, что продаётся за счёт того, что его находят, ответ почти всегда положительный, а OAI-SearchBot, тот самый, который возвращает ссылки, останавливать хочется в последнюю очередь.
А затем, прежде чем что-либо менять, проверьте, что вы уже получаете от этих систем. Наш AI Visibility Checker задаёт 6 покупательских вопросов основным ассистентам и отдельно считает упоминания и цитаты со ссылками, а это и показывает, есть ли вообще трафик, который надо защищать.
Блокировка краулера, это решение о трафике, который вы, возможно, не измеряли. Проверьте, что ассистенты говорят сейчас и присылает ли вам кто-нибудь из них людей, прежде чем править файл.
- 6 покупательских вопросов, заданных без вашего бренда в тексте
- Упоминания и цитаты считаются отдельно
- 3 проверки в день, без регистрации и без карты
Что мы измерить не смогли
А вот чего это исследование не показывает. Пара инструментов, названных на этом сайте, наши партнёры: если вы купите по этим ссылкам, мы получим комиссию, а вы не заплатите ни цента больше.
robots.txt, это просьба, а не запрет. Он фиксирует, о чём сайт просит. Он не говорит, послушался ли хоть один краулер, и проверить соблюдение снаружи мы никак не можем. Заблокированный краулер в этих данных, это заявленное намерение.
Мы тестировали 18 названных краулеров и засчитывали блокировку только при Disallow: / на весь сайт внутри группы, где этот агент назван. Правила на уровне путей, crawl-delay и агенты с масками не учитывались, поэтому сайт, который закрывает ИИ-краулеру большую часть сайта, но не весь, проходит здесь как не блокирующий.
2 из 67 доменов вообще не отдали файл, это npmjs.com и rust-lang.org, поэтому знаменатель везде 65.
Выборка, это 67 доменов, которые мы выбрали по 6 категориям, с перевесом в сторону компаний, знакомых SEO-аудитории, и случайной выборкой веба она не является. Другой список даст другую долю. Метод лежит в scripts/survey-ai-crawler-files.mjs в нашем репозитории, а сырой вывод в evidence/surveys/.
Частные лицензионные соглашения нам не видны, и эта версия статьи ничего о них не утверждает. Ранняя версия утверждала, опираясь на гораздо меньшую выборку, и это утверждение мы убрали, а не переформулировали.
Частые вопросы
Сколько сайтов блокируют ИИ-краулеров?
17 из 65, которые мы смогли прочитать, то есть 26%, замер 6 сентября 2026 года по 18 названным ИИ-краулерам. Блокируют все 9 медиа, 4 ритейлера из 7, 4 SaaS-компании из 18 и ни один из 31 домена инструментов для разработчиков, SEO-инструментов и ИИ-лабораторий.
Какого ИИ-краулера блокируют чаще всего?
CCBot, его блокируют 14 из 17 блокирующих сайтов. Он принадлежит Common Crawl, некоммерческой организации, которая архивирует веб с 2008 года, задолго до нынешних переживаний об обучающих данных. GPTBot блокируют 9 сайтов, а OAI-SearchBot 6.
Блокируют ли медиа ИИ-краулеров?
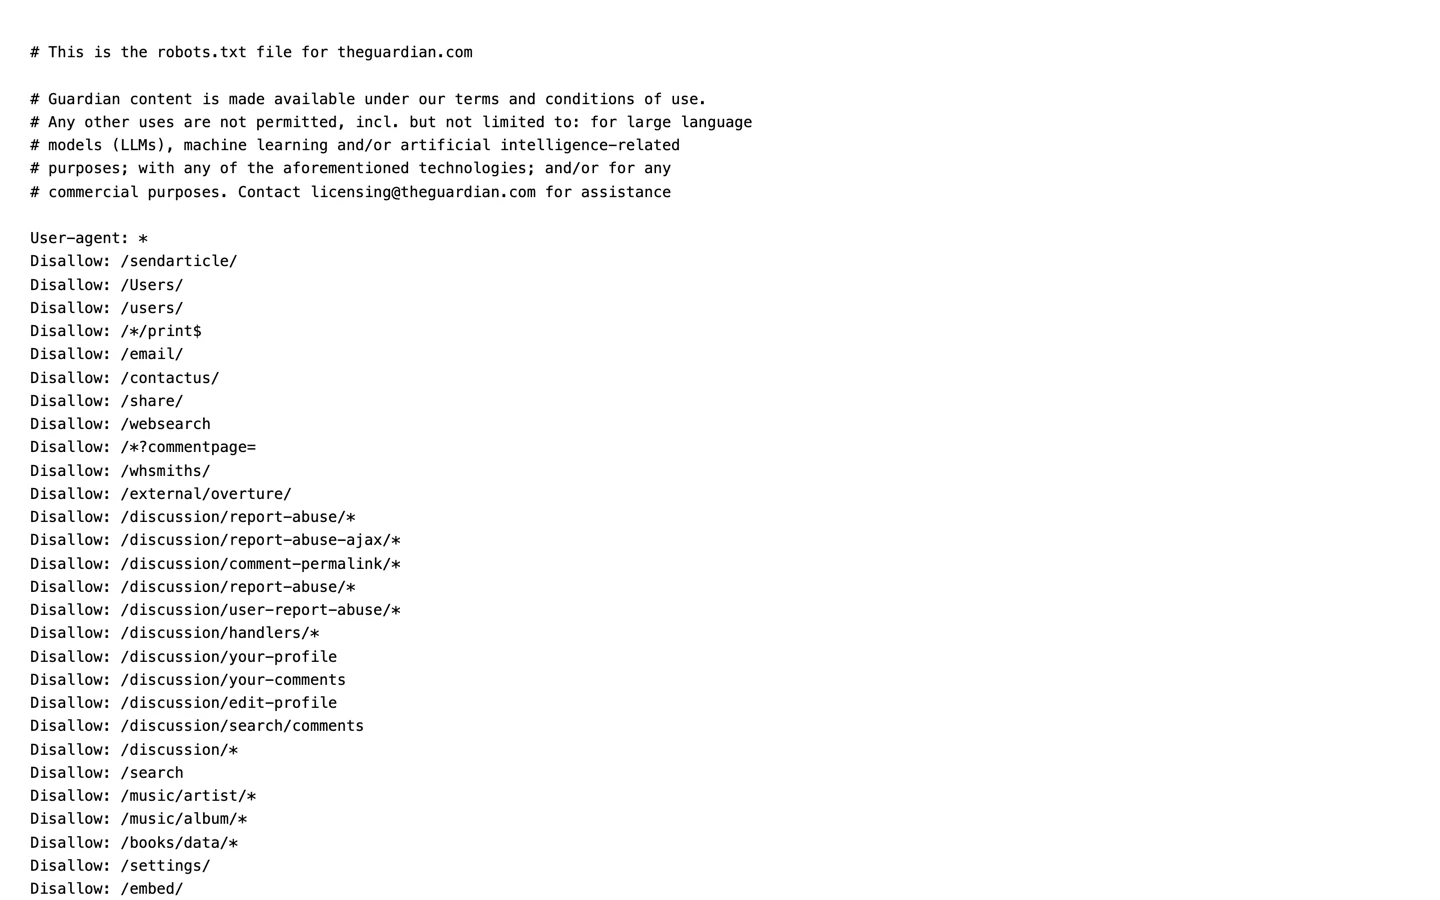
Все 9 в нашей выборке, в среднем по 14.1 краулера из 18 у каждого. The New York Times и wikiHow блокируют 17, CNN 17, The Verge и BBC 15, Investopedia 14, Wired 12, Healthline 11 и the Guardian 9.
Anthropic блокируют чаще, чем OpenAI?
Немного чаще. 13 из 17 блокирующих сайтов останавливают хотя бы один краулер Anthropic против 10 для OpenAI, а OAI-SearchBot блокируют реже всех в исследовании, всего 6 сайтов. И только 2 сайта блокируют все краулеры Anthropic, пропуская при этом все краулеры OpenAI.
Стоит ли блокировать ИИ-краулеров на своём сайте?
Это следует из вашей бизнес-модели. Если люди платят за чтение ваших страниц, блокировка защищает то, что вы продаёте. Если ваши страницы существуют, чтобы их нашли и по ним что-то сделали, блокировка убирает вас из ответа, а OAI-SearchBot, краулер, который с наибольшей вероятностью пришлёт посетителя по ссылке, останавливать хочется в последнюю очередь.
robots.txt действительно останавливает краулер?
Это просьба, а не запрет. Файл фиксирует, о чём просит сайт; ничто в нём ничего не обеспечивает принудительно, и проверить соблюдение снаружи мы никак не можем. Любая цифра «блокирует» здесь, это заявленное намерение.
Почему grep по имени бота в robots.txt даёт неверный ответ?
Потому что назвать краулер, не значит его заблокировать. В наших 65 файлах 91 упоминание краулеров сидит в разрешающих группах, где все правила только на уровне путей. Краулер считается заблокированным, только когда в группе, где он назван, есть Disallow: / на весь сайт.
Блокируют ли SEO-инструменты ИИ-краулеров?
Ни один из 8 проверенных, включая нас. И ни один из 16 сайтов инструментов для разработчиков и 7 ИИ-лабораторий. Софтверные компании хотят, чтобы их документацию читали.
Одна цифра, которую стоит запомнить
31 к 0.
Столько софтверных компаний в этом исследовании блокирует ИИ-краулера: ни одна, против 9 медиа из 9.
Никакой общепринятой best practice в этих данных не прячется, потому что 2 группы отвечают на разные вопросы. Медиа спрашивает, можно ли машине заменить собой его продукт. Софтверная компания спрашивает, можно ли машине рекомендовать её продукт.
Ответить за вас не может никто, и ни один список блокировок, скопированный из статьи в блоге, за вас на это не ответил. Самый блокируемый краулер в этом исследовании принадлежит некоммерческому архиву, который старше всей этой дискуссии, и это хорошо показывает, насколько содержимое таких файлов было решено, а насколько просто унаследовано.
Откройте свой robots.txt. Это 5 минут, а сейчас он делает от вашего имени заявление, которого вы, возможно, никогда не делали.
Замер 6 сентября 2026 года. Мы запросили robots.txt у 67 доменов, разобрали 65 из них по группам user-agent и засчитывали краулер как заблокированный, только если в группе, где он назван, был Disallow: / на весь сайт. Тестировались 18 краулеров: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, anthropic-ai, Claude-User, Google-Extended, CCBot, PerplexityBot, Bytespider, Applebot-Extended, meta-externalagent, Amazonbot, cohere-ai, Diffbot, omgili, ImagesiftBot и Timpibot. Метод лежит в scripts/survey-ai-crawler-files.mjs в нашем репозитории, а сырые результаты в evidence/surveys/, так что любую цифру отсюда можно перепроверить.